
ステップバイステップガイド · 2026
AI であなたのブランドの可視性をどう高めるか?
AI 検索 — ChatGPT、Claude、Perplexity、Google AI Overviews、Gemini、DeepSeek — でブランド可視性を高めるための 9 つの順序あるステップのプレイブック。各ステップには: なぜ、何をするか、完了をどう確認するか、実例、そして数週間を数分に圧縮する RankCaster の 可視性ツール。ガイドを終える頃には「ChatGPT に見えない」状態から APR 50〜60% 帯 — 自社 + 外部の層 — にブランドを移動させます。
始める前に · 3 分
3 分で語彙を揃える
各ステップで繰り返し使う 2 つの指標と、実作業のプログラムを駆動するスタック 1 つ。
45%サンプル
AI がどれだけ頻繁にあなたを名指すか
あるプロンプトに対する AI 回答のうち、ブランドが言及されるシェア (名前が現れるすべてのケース — 中立・推薦・比較を問わず)。可視性の診断指標であり、感情指標ではない: 推薦 vs 中立トーンの区別はブランドトラッカーで別途扱う。
12%サンプル
AI がどれだけ頻繁にあなたを出典として引用するか
AI 回答のうち、あなたのドメインが出典リストに現れるシェア。並行して全ドメイン (競合、G2、Reddit) の引用シェアを追跡 — AI が実際にあなたの代わりに誰を出典として扱っているかを見る。
ルール
高い APR + 低い BSCR = AI はあなたを知っているが、他から学んでいる。その他が書き直された日、あなたの APR は落ちます。これがプログラム全体の中心的な診断シグナル。
作業スタック · Auditor 600 以上のルール
AIO → AEO → GEO · 3 つの異なる仕事
下から順に修正する。クローラーが取れないページ上の美しいスキーマグラフはゼロ点です。
テキストを引用されるように書く
AI は別々のページから回答を組み立てるのが嫌い — 回答が 1 つのブロックとして書かれているページを選びます。実務では: キーページの各段落が特定の質問に単独で答える、隣を指さない。最初の文は直接の答え、残りは詳細・数字・例。長さ — 40〜80 語: 短いと AI は文脈を失い、長いと競合を選ぶ。
ルール例: 水増しフレーズ禁止 (「現代の世界では」「最先端のソリューション」); 各 H2 は購入者が聞く質問; H2 下の段落は最初の文で直接答える; 各数字と事実は具体的 — 「多くの」「最近」禁止; 指示対象が不明確な代名詞 (「これ」「そのアプローチ」) 禁止。
AI にそれが何のオブジェクトか伝える
AI にとってページは単なるテキストの壁ではなく、特定のオブジェクトです: 価格のある製品、オフィスのある会社、専門家の著者がいる記事。それを AI に見せるには、ページ上の人間向けテキストに機械可読マークアップ (Schema.org) — 各ブロックがどんなエンティティかを説明する目に見えないラベル — を添える。それなしでは AI はあなたのブランドを類似名の別企業と混同したり、記事を他人の著者に帰属させたり、製品価格を競合ページから拾ったりします。
ルール例: 会社ページに名前・住所・ロゴ付きの Organization ブロック; 製品ページに価格・通貨・在庫付きの Product ブロック; 記事ページに著者名・役職・雇用主・公開日付きの Article ブロック; sameAs フィールドにエンティティの全外部プロフィール (LinkedIn、Crunchbase、Wikipedia) を列挙; 各ブロックにリリース間で変わらない安定した @id; マークアップが Schema.org 仕様に対して検証を通る (自動チェック)。
AI をサイトに入れる
AI 検索は Google とは別のボットでサイトをクロール: ChatGPT は GPTBot、Claude は ClaudeBot、Perplexity は PerplexityBot、Gemini は Google-Extended、その他いくつか。サイトが誤ってそれらをブロックしたり空のページを返したら (例えば JavaScript 実行後にしかコンテンツが出ない — ボットは JS を実行しない) — それ以外のすべては無駄な作業。Google からは問題なく見え続けるので、あなたは気づかないまま終わります。
ルール例: robots.txt が 6 つの主要 AI ボットをキーページで明示的に許可; User-Agent: GPTBot/1.0 の curl が 200 OK と実ページテキストを返す (リダイレクトではない); 初期 HTML (JavaScript 実行前) が 500 語以上の意味あるコンテンツを含む; ボットが人間と同じ HTML を受け取る (「簡略化されたサーバー版」ではない); サイトルートに llms.txt — 会社の簡潔な要約と主要ページへのリンク。
105 / 430 / 63 の分割は RankCaster Auditor 独自の方法論であり、業界合意の分類ではない: AEO と GEO は文献でアンブレラ語として現れ、AIO はクローラビリティ層の私たちのラベルです。全ルールセット、出典 (Schema.org、Google Rich Results、OpenAI / Anthropic ドキュメント)、層境界の根拠は 完全な方法論に。
9 つのステップ · 順番通り
01 · ステップ 1 / 9
誰に売るのか
アウトカム — 購入者ポートレート: どの会社、そして社内の誰か。ステップ 2 のプロンプトはここから生まれます。
なぜこのステップか
同じ会社の中で、同じ製品について 3 人がそれぞれ違う聞き方をします — そして ChatGPT は 3 人それぞれに異なるブランドリストを返します。「平均的な顧客」向けにプロンプトを書けば、誰も実際には打ち込まないプロンプトが出来上がります。
何をするか
- 1.製品を 3〜5 行で。何をして、何にお金を取り、AI があなたの隣に挙げる競合とどう違うのか。
- 2.購入する会社。業界、従業員数、すでに使っているもの、通常いつ買う準備ができるか。
- 3.取引を動かす社内の 2〜4 人。通常は: 支払う人、痛みを抱える人、セキュリティを審査する人、毎日使う人。
- 4.各人につき 2〜3 のプロンプト。チャット調で、完結した質問として。「CLM Salesforce」ではなく「300 名の弁護士チーム向けに Salesforce と連携する CLM を推薦して」のように。
完了チェック
ページには 1 社、2〜4 人、1 人あたり 2 本以上のプロンプトが揃っていること。プロンプトが出てこなければ — その人物のポートレートをもっと埋めること。
例
例 · 法務チーム向け契約管理ソフトウェア
会社: 従業員 200〜1,000 名の SaaS。Salesforce と Slack を利用。年間 300 件以上の契約を締結。意思決定に 2〜3 か月。
取引を動かすのは 3 人:
| 誰 | 何をする | AI に何を聞く |
|---|---|---|
| 法務統括 (General Counsel) | 課題を持ち込み、製品を引き込む | 「なぜうちの弁護士は契約業務に溺れているのか」 |
| 法務オペ責任者 | 予算を持ち、請求書に署名する | 「Salesforce と連携する契約管理ツールはどれ」 |
| IT 責任者 | セキュリティと連携を審査する | 「Ironclad と Icertis — どちらがセキュアか」 |
1 つの製品、1 件の購買 — しかし AI には 3 つの異なる質問。3 つの異なる回答、3 つの異なるブランドセット。これがステップ 2 の原材料です。
方法論
さらに深く学ぶなら:
- Five Levels of Awareness, Josh Kaufman — Schwartz の Breakthrough Advertising のアイデアを短く解説: なぜ「契約レビューを早める方法」と「Ironclad vs Icertis」が別の人物によって聞かれるのか。
- Know Your Customers' Jobs, HBR — 顧客が本当に何のためにあなたから買っているかを言語化する方法。
- How to identify your ideal customer, Lenny — スタートアップとのインタビューから作られた購入会社ポートレートのチェックリスト。
- Buyer persona questions, HubSpot — 顧客インタビューから人物ポートレートを組み立てる質問集。
- Navigating purchase behavior and decision-making, Think with Google — 購入者が課題認知から購買までどう動くか、そしてステップ 2 のプロンプトに変換できるシグナル。
RankCaster ではこう見える
Products & Services → Persona → Target Audience Segments
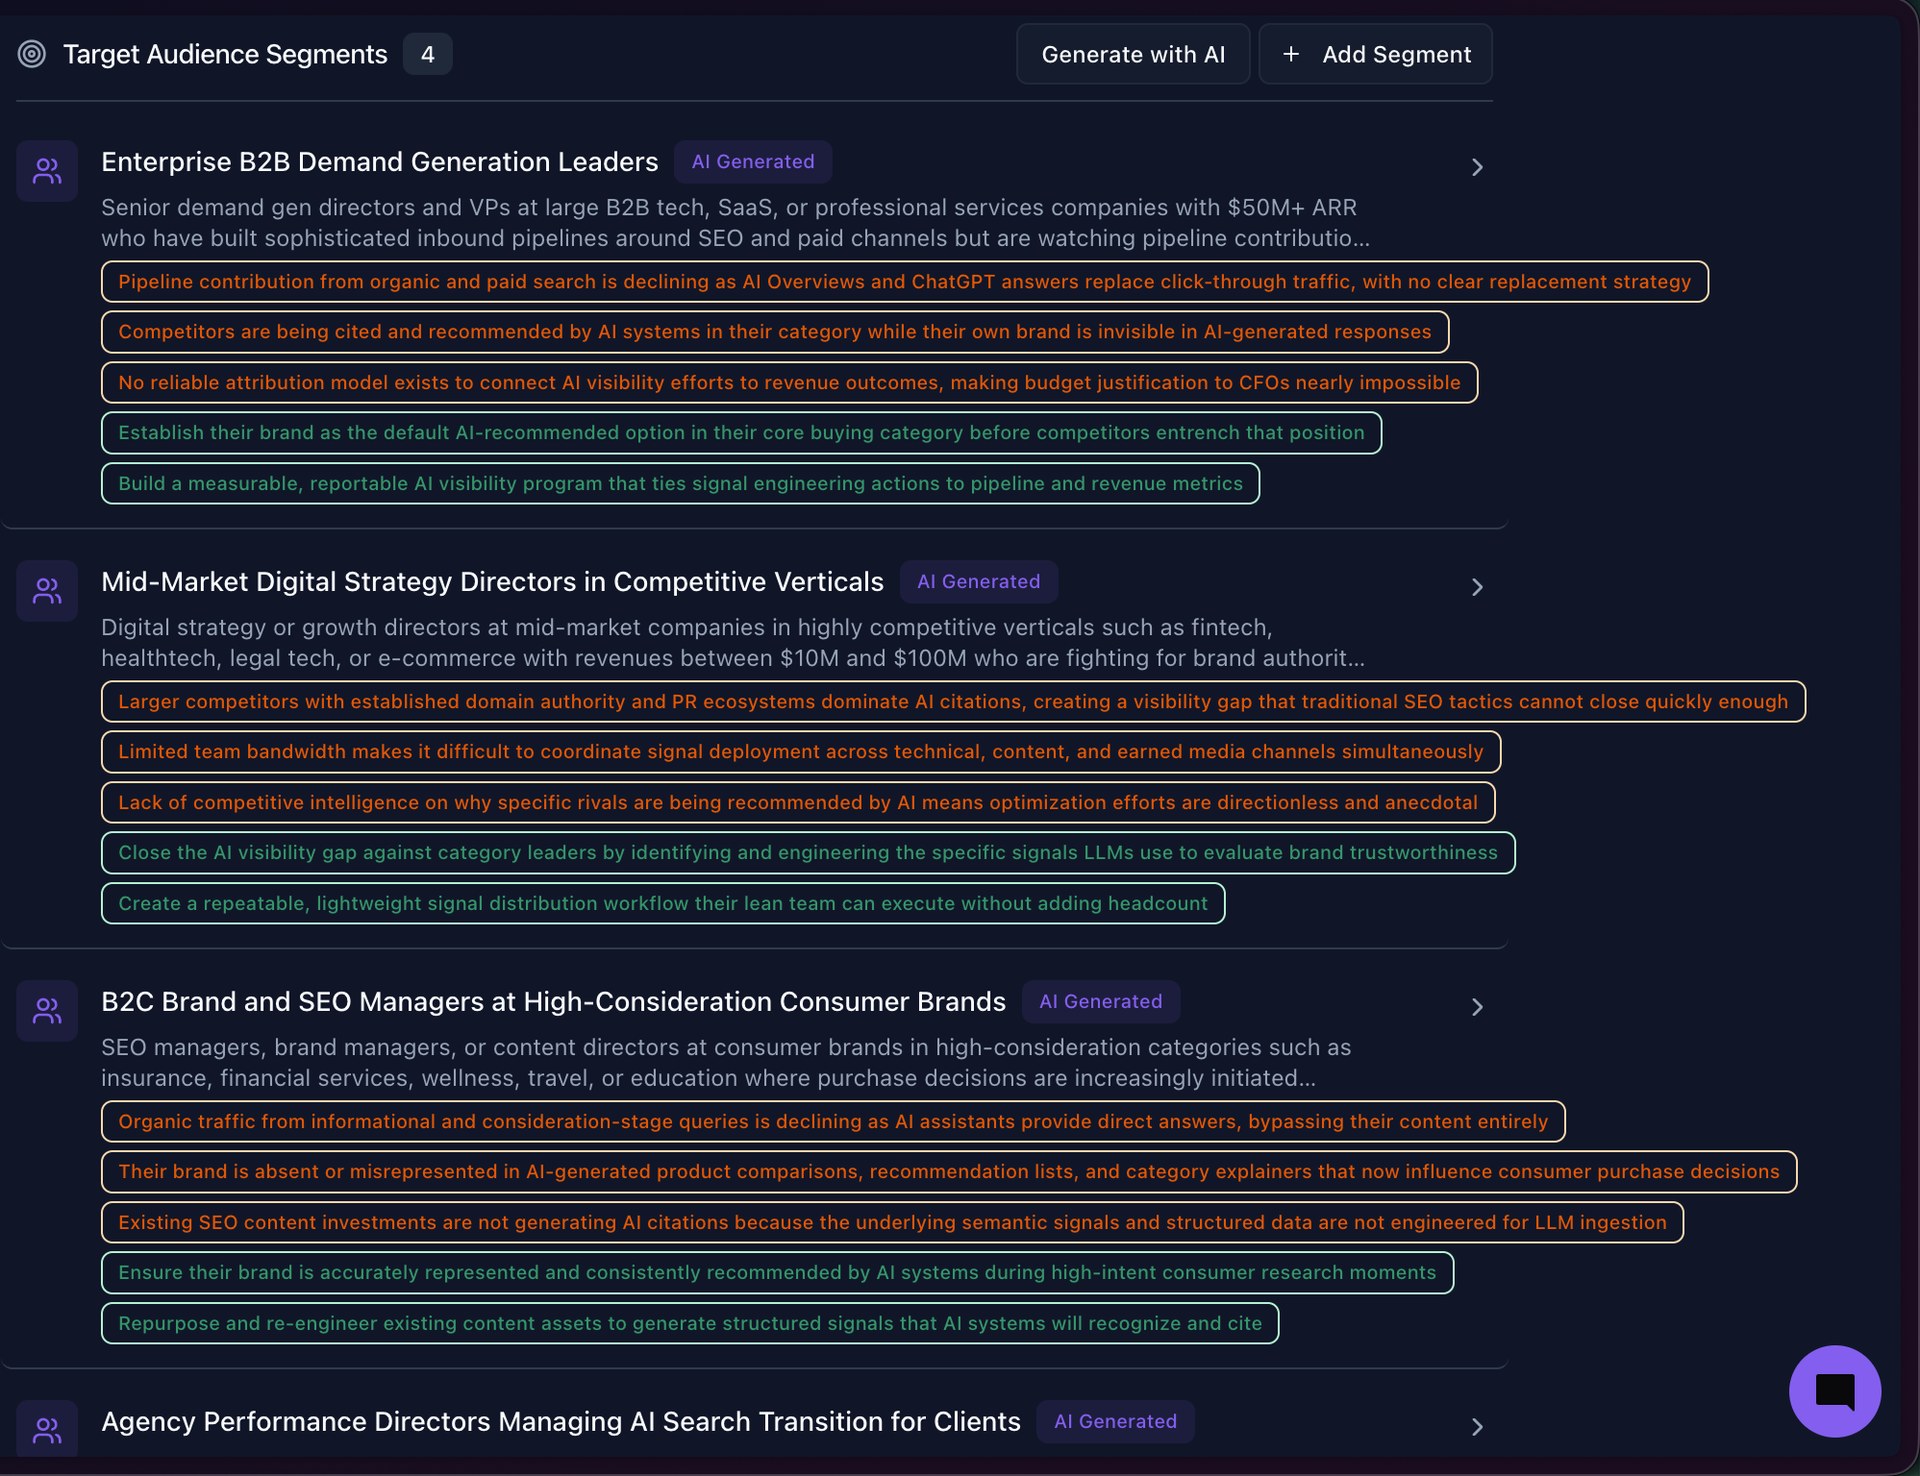
3 つのモジュールがステップ 1 を数分で実行します。システムがあなたのサイトを自ら読み込み、会社・製品・サービスの説明を抽出します。同じ入力から市場セグメンテーションと取引を動かす人物のポートレートを構築します — あなたの仕事はレビューと微調整だけ。出力: ステップ 2 にそのまま持ち込める、人物とその質問のリスト。
02 · ステップ 2 / 9
AI に聞かれる 20 の質問を書く
アウトカム — 購入者の認知段階でタグ付けされた 20 の質問のリスト。下流のすべての計測はこの上に乗ります。
なぜこのステップか
キーワードではなく質問を測る: 人々が実際に ChatGPT に打ち込むのはそれだから。リストが変わり続ければ比較対象がなくなり、計測は毎回ゼロからのスタートになります。
20 の質問は 3 つの役割に分かれ — それぞれ営業における意味が異なります。市場形成型 — 購入者はまだ解決策を探しておらず、課題に気づき始めたばかり (「なぜうちの弁護士は契約業務に溺れているのか」「契約レビューを早める方法」) — あなたは最初に頭に入ります。需要対応型 — 購入者は解決策のカテゴリを探している (「Salesforce 連携の契約管理ソフトウェア」) — トラフィックの大半と競争の大半がここ。頭対決型 — 購入者は特定の製品を比較している (「Ironclad vs Icertis」「Ironclad の代替」) — 取引への道は短いが AI 回答にはすでに競合がひしめいているので入り込むコストは高い。
3 つのグループの比率は戦略的選択です。市場形成型を増やす — 長期戦、将来の需要を創る。頭対決型を増やす — 特定のブランドから今すぐ顧客を剥がす試み。20 は維持できる上限です。
何をするか
- 1.ステップ 1 の各人物につき 2〜4 問。チャット調で、完結した文として言い回す。
- 2.各質問に役割タグを付ける: 市場形成型 / 需要対応型 / 頭対決型。妥当な出発点 — それぞれ 6〜7 問ずつ。プランニング期間に合わせて後で調整。
- 3.質問にブランド名を入れない。さもなくば自社名への反応を測ることになり、可視性ではなくなります。
- 4.リストと日付を凍結する。質問を編集したら新しい日付を記録し、カウントはそこからやり直し。
完了チェック
あなたの会社を知らない読者がリストから読み取れること: どんなビジネスか、どの課題を解決するか、誰と競合するか — そして各質問が 3 つの役割のどれを果たすか。
例
例 · 契約管理ソフトウェア
- · 「ミッドマーケット法務チーム向けベスト契約管理ソフトウェア」 (比較)
- · 「Salesforce と連携する契約レビューツール」 (選定)
- · 「200 名規模の会社向け Ironclad の代替」 (反論)
- · 「エンタープライズ契約管理のシート単価はいくらか」 (価格)
RankCaster ではこう見える
Prompt Intelligence
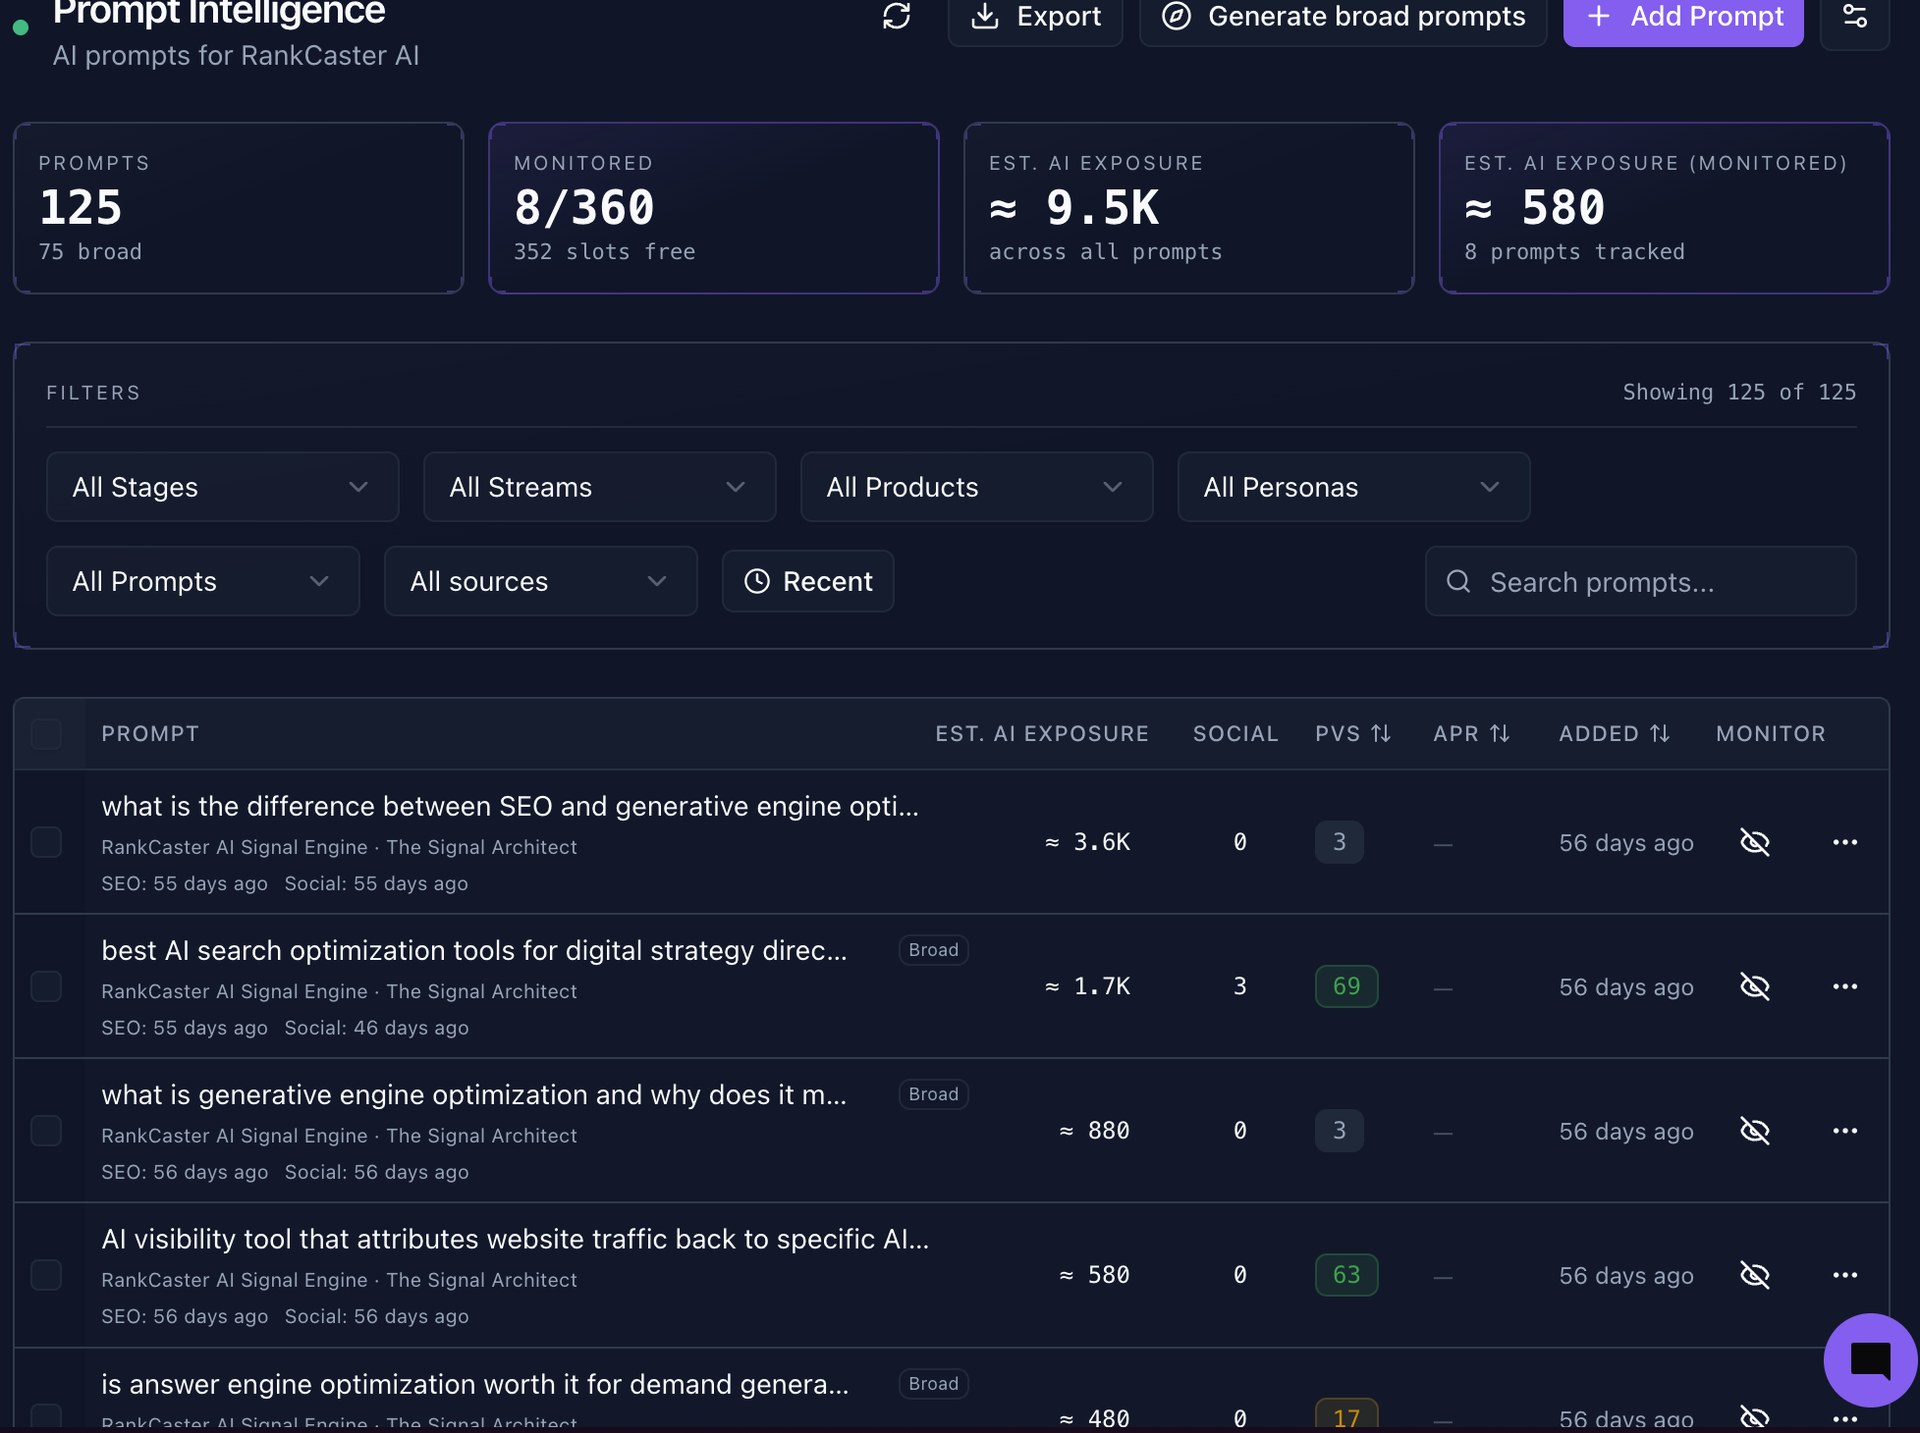
このセクションはステップ 1 の人物とその認知段階を取り込み、それらの人物が AI に聞く質問を提案します — すでに 3 つの役割 (市場形成型・需要対応型・頭対決型) に分類済み。各質問について要点が見えます: どれほどの頻度で聞かれ、営業にとってどれほど価値があるか。必要な 20 問を選んで監視に送るだけ — 手作業で何時間ではなく数分で。
03 · ステップ 3 / 9
最初の計測を取る
アウトカム — 表: 各質問について、AI が 10 回中何回あなたを言及し、何回あなたのサイトにリンクしたか。モデルごとに別々に。
なぜこのステップか
AI は同じ質問に毎回少しずつ違う答えを返します。1 回の実行では何もわかりません — 同じ質問を 10 回連続で投げ、何回の回答にあなたが入っているかを見る。それが正直な数字です。
6 モデル — 6 つの別々の計測。それぞれ独自の検索エンジン (独自のインデックス、独自の信頼サイトリスト)、独自の情報源選定・ランク付けアルゴリズム、学習から来る独自の内部記憶を持ちます。検索に行くか記憶から答えるかは各モデルが質問に応じて独自に判断します。同じ質問に対して ChatGPT、Perplexity、Gemini、Google AI Overviews、Claude、DeepSeek は異なるブランドを含む異なる回答を返します — 平均化しても意味はありません、異なるデータと異なるルールで動いているので。
2 つのことを同時に測る。1 つめ — 回答で言及されたか (APR)。2 つめ — 出典リストにあなたのサイトが現れたか (BSCR)。2 つの異なるシグナル、2 つの異なる状況: AI は他人のブログを引用しつつあなたを称賛することも、あなたを引用しつつ名指ししないこともあります。
各言及の文脈もタグ付けする — 単純な言及、能動的な推薦、比較のいずれか。言及 / 推薦 / 引用は 3 つの異なるアウトカム。これを 1 つの数字に潰すと、「言及率」が上昇しているように見えて「推薦」が下落していることを隠せる — APR が健全に見えつつ、AI は静かに他社を代わりに勧め始めています。
何をするか
- 1.各質問を 6 モデル全部に順番に投げる: ChatGPT、Claude、Perplexity、Gemini、DeepSeek、Google AI Overviews。デフォルト設定で — 通常のユーザーが見るモードで。
- 2.同じ質問を同じ設定で 1 日のうちに 10 回実行する。
- 3.各モデルについて 2 つの数字を記録する: 10 回の回答のうちブランドが言及されたのは何回 (APR)、そのうち出典にあなたのサイトが現れたのは何回 (BSCR)。モデルが出典を返さなかった場合は — 2 つめのセルは空欄にする、捏造しない。
完了チェック
表: 行が質問、列が 6 モデル、各セルに 2 つの数字。商用質問で最初に 5〜15% は正常です。
例
1 つの計測行の例
| 質問 | ChatGPT | Claude | Perplexity |
|---|---|---|---|
| best contract management software | 10 回中 1 | 10 回中 0 | 10 回中 3 |
さらに深く — 私たちの調査
ベンダ自身が言うこと
ChatGPT、Claude、Perplexity、Google、Bing の公式ドキュメント — ポリシー変更のたびに再確認する価値のある一次情報源。
- Claude Web Search tool — Claude がウェブに当たり引用を返す仕組みAnthropic Docs
- AI features and your website — サイトオーナーに見えるもの (AI Overviews, AI Mode)Google Search Central
- Microsoft Copilot Chat とエージェントのウェブ検索の仕組みMicrosoft Support
RankCaster ではこう見える
AI Visibility
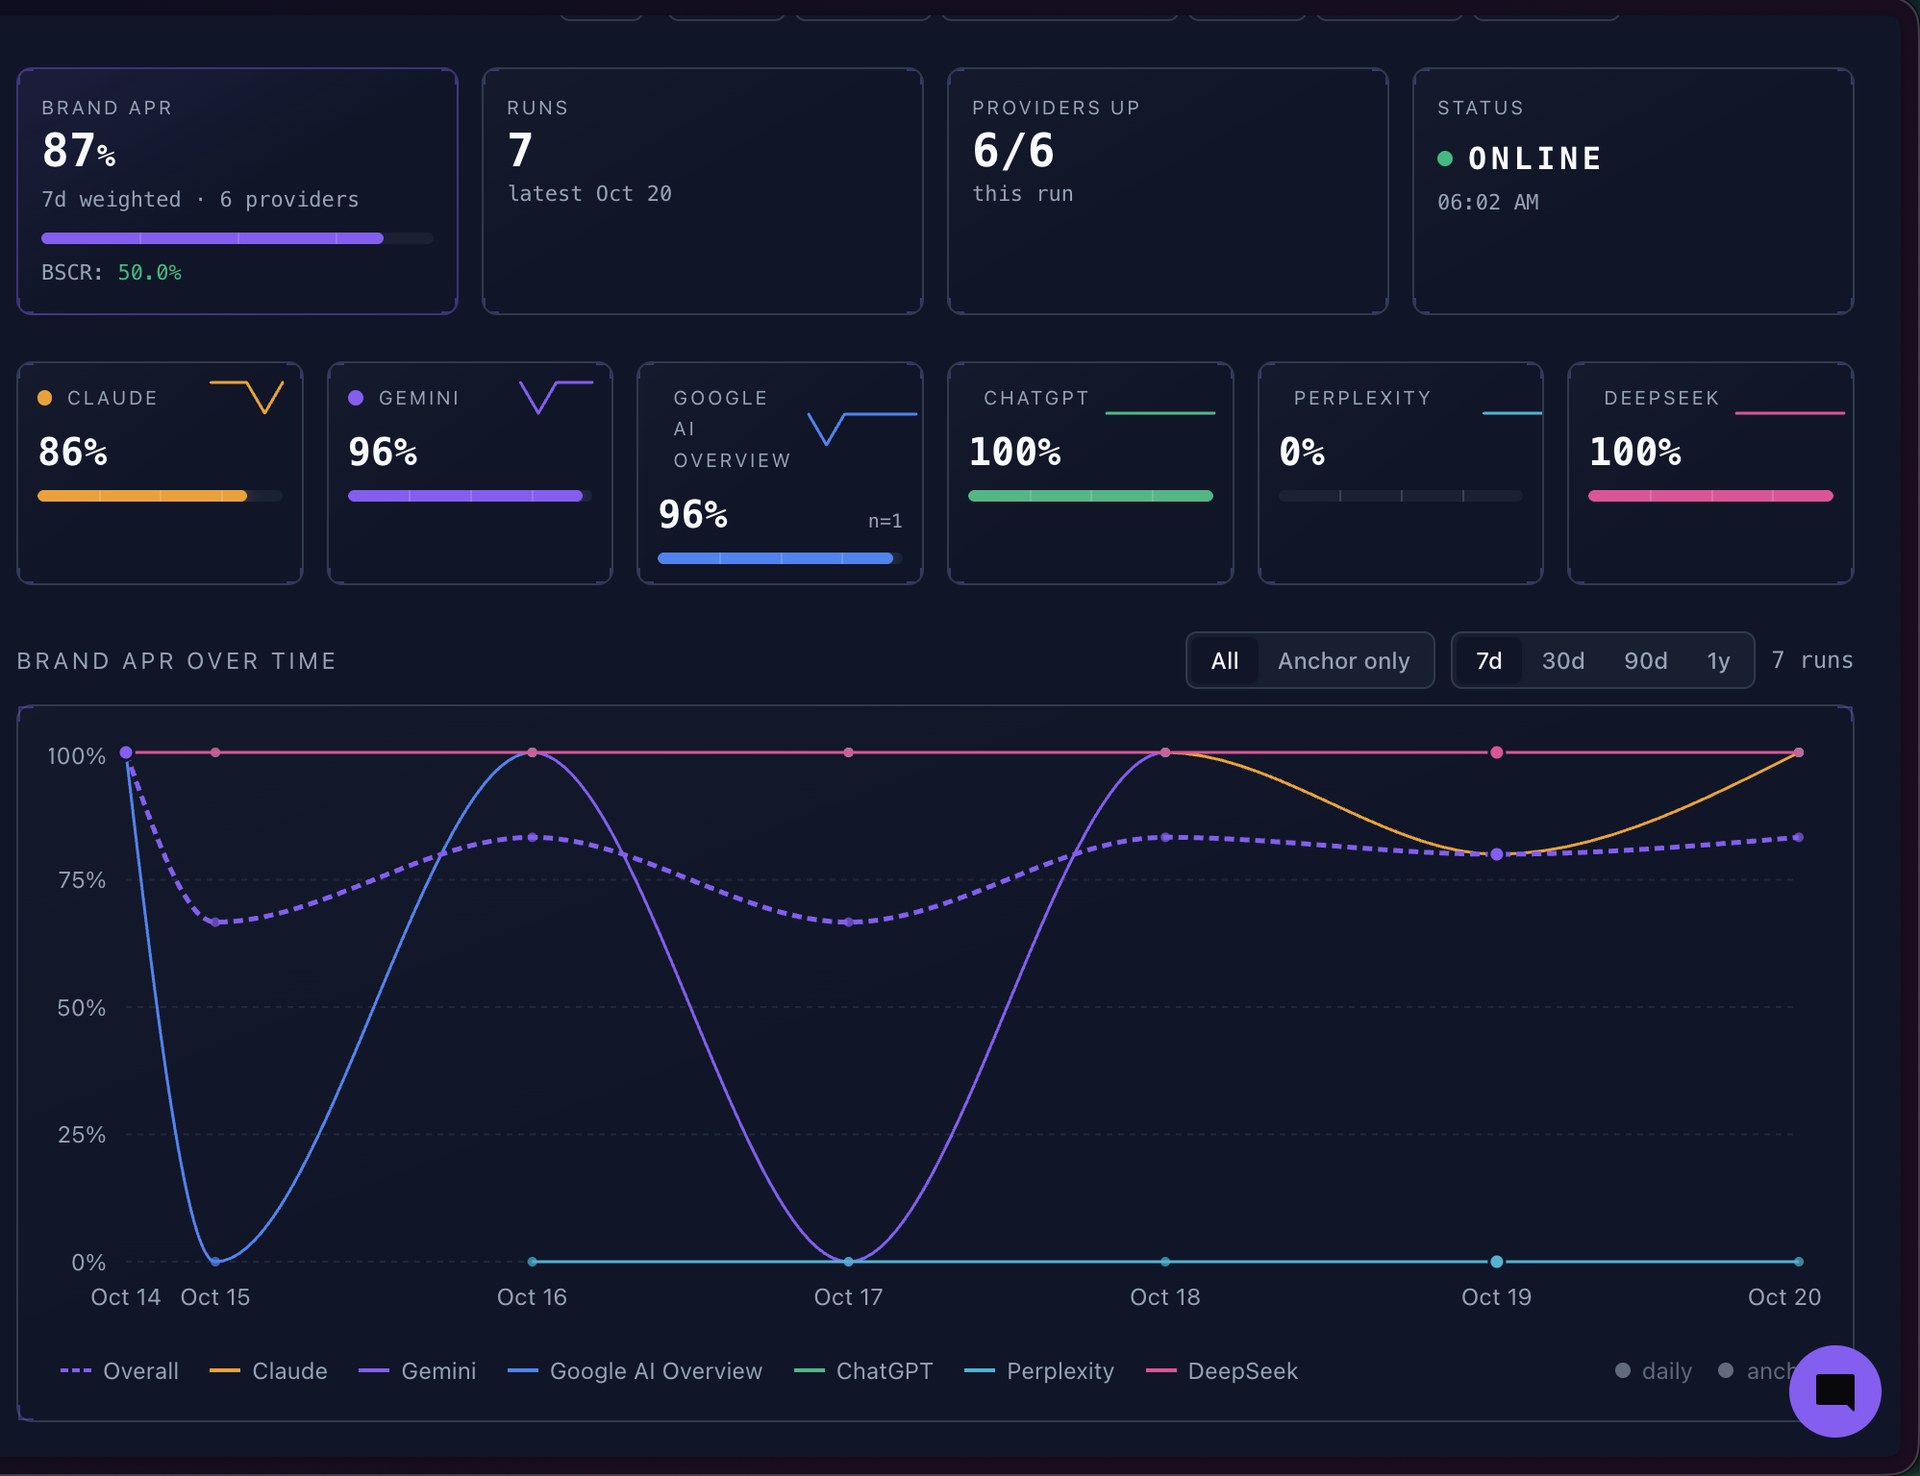
ダッシュボードがあなたの代わりに計測します: 各質問を 6 モデル全部に投げ、10 回ずつ繰り返し、質問×モデルごとに 2 つの数字を表示。データは日次で更新 — 週・月・年の視点で見られ、AI があなたの代わりに誰を引用しているか、追うべき外部サーフェスはどれかがわかります。
04 · ステップ 4 / 9
AI が本当にあなたのサイトを見られるか確認する
アウトカム — あなたのページが主要な AI ボットに対して開かれ、きれいなテキストを返す。
なぜこのステップか
AI 検索は Google とは別の独自クローラーを持ちます。サイトがそれをブロックすれば — 偶然であれ意図であれ — あなたのページから一語も ChatGPT、Claude、Perplexity に届きません。Google からは問題なく見え続けるので、あなたは気づかないまま終わります。
これが最初にチェックすべきこと。AI がページを読めなければ、下流のすべては無駄な作業です。
何をするか
- 1.robots.txt で 6 つの AI ボットへのアクセスを開ける: GPTBot (ChatGPT)、ClaudeBot (Claude)、PerplexityBot (Perplexity)、Google-Extended (Gemini)、CCBot、Bytespider。
- 2.OpenAI の 3 種のボットについては別々に判断する — 役割が違います。OAI-SearchBot は ChatGPT 検索の発見を担うのでアクセスが必要。GPTBot はあなたのコンテンツがモデル学習に使われる可能性を制御する — 別のビジネス判断です。ChatGPT-User は特定ユーザーが要求したときにページを取得する。一律ブロックしない — 何を許し何を許さないかを決める。
- 3.llms.txt をサイトに置く — 会社の簡潔な要約と主要ページへのリンク。これを読むことを公式にコミットしたプロバイダはいないが、ファイルは安価で、あなた自身のキャノニカルな事実セットとして有用 (例を下に)。
- 4.主要ページは JavaScript なしですぐテキストを表示すること。簡単なチェック: ブラウザで「ソースを表示」して、コンテンツを探す。ほとんどの AI ボットは JS を実行しません。
- 5.ボットには人間と同じものを出す。ボット向けの特別な「サーバー版」をレンダリングするなら、テキストが人間版と一致していることを検証する。
完了チェック
ターミナルコマンド curl -A 'GPTBot/1.0' yourdomain.com/key-page が 200 を返し、応答がページの重要なテキストを含んでいること。これなしでは下流のすべてが無駄。
例
最小限の llms.txt
# Example Co.
Contract-management software for mid-market legal teams.

## Primary pages
- https://example.com/product
- https://example.com/pricing
- https://example.com/customers

## Facts
- Founded: 2019
- Headquarters: Austin, TX
- Integrations: Salesforce, HubSpot, DocuSign
さらに深く — 私たちの調査
ベンダ自身が言うこと
ChatGPT、Claude、Perplexity、Google、Bing の公式ドキュメント — ポリシー変更のたびに再確認する価値のある一次情報源。
- OpenAI クローラー概要 — OAI-SearchBot (検索)、GPTBot (学習)、ChatGPT-User (ユーザー起動)、OAI-AdsBotOpenAI Developers
- Anthropic はウェブからデータをクロールするか — ClaudeBot、Claude-User、Claude-SearchBot と robots.txtAnthropic Support
- Perplexity Crawlers — PerplexityBot (検索) と Perplexity-User (ユーザー起動)Perplexity Docs
- Google クローラーとフェッチャー概要 — Googlebot と他の user-agentGoogle Search Central
- Google の共通クローラーリスト — Google-Extended と GoogleOtherGoogle Search Central
- Bing が使うクローラー (Bingbot — Copilot への道)Bing Webmaster Help
RankCaster ではこう見える
AI-readable files + Auditor (AIO, 105 ルール)
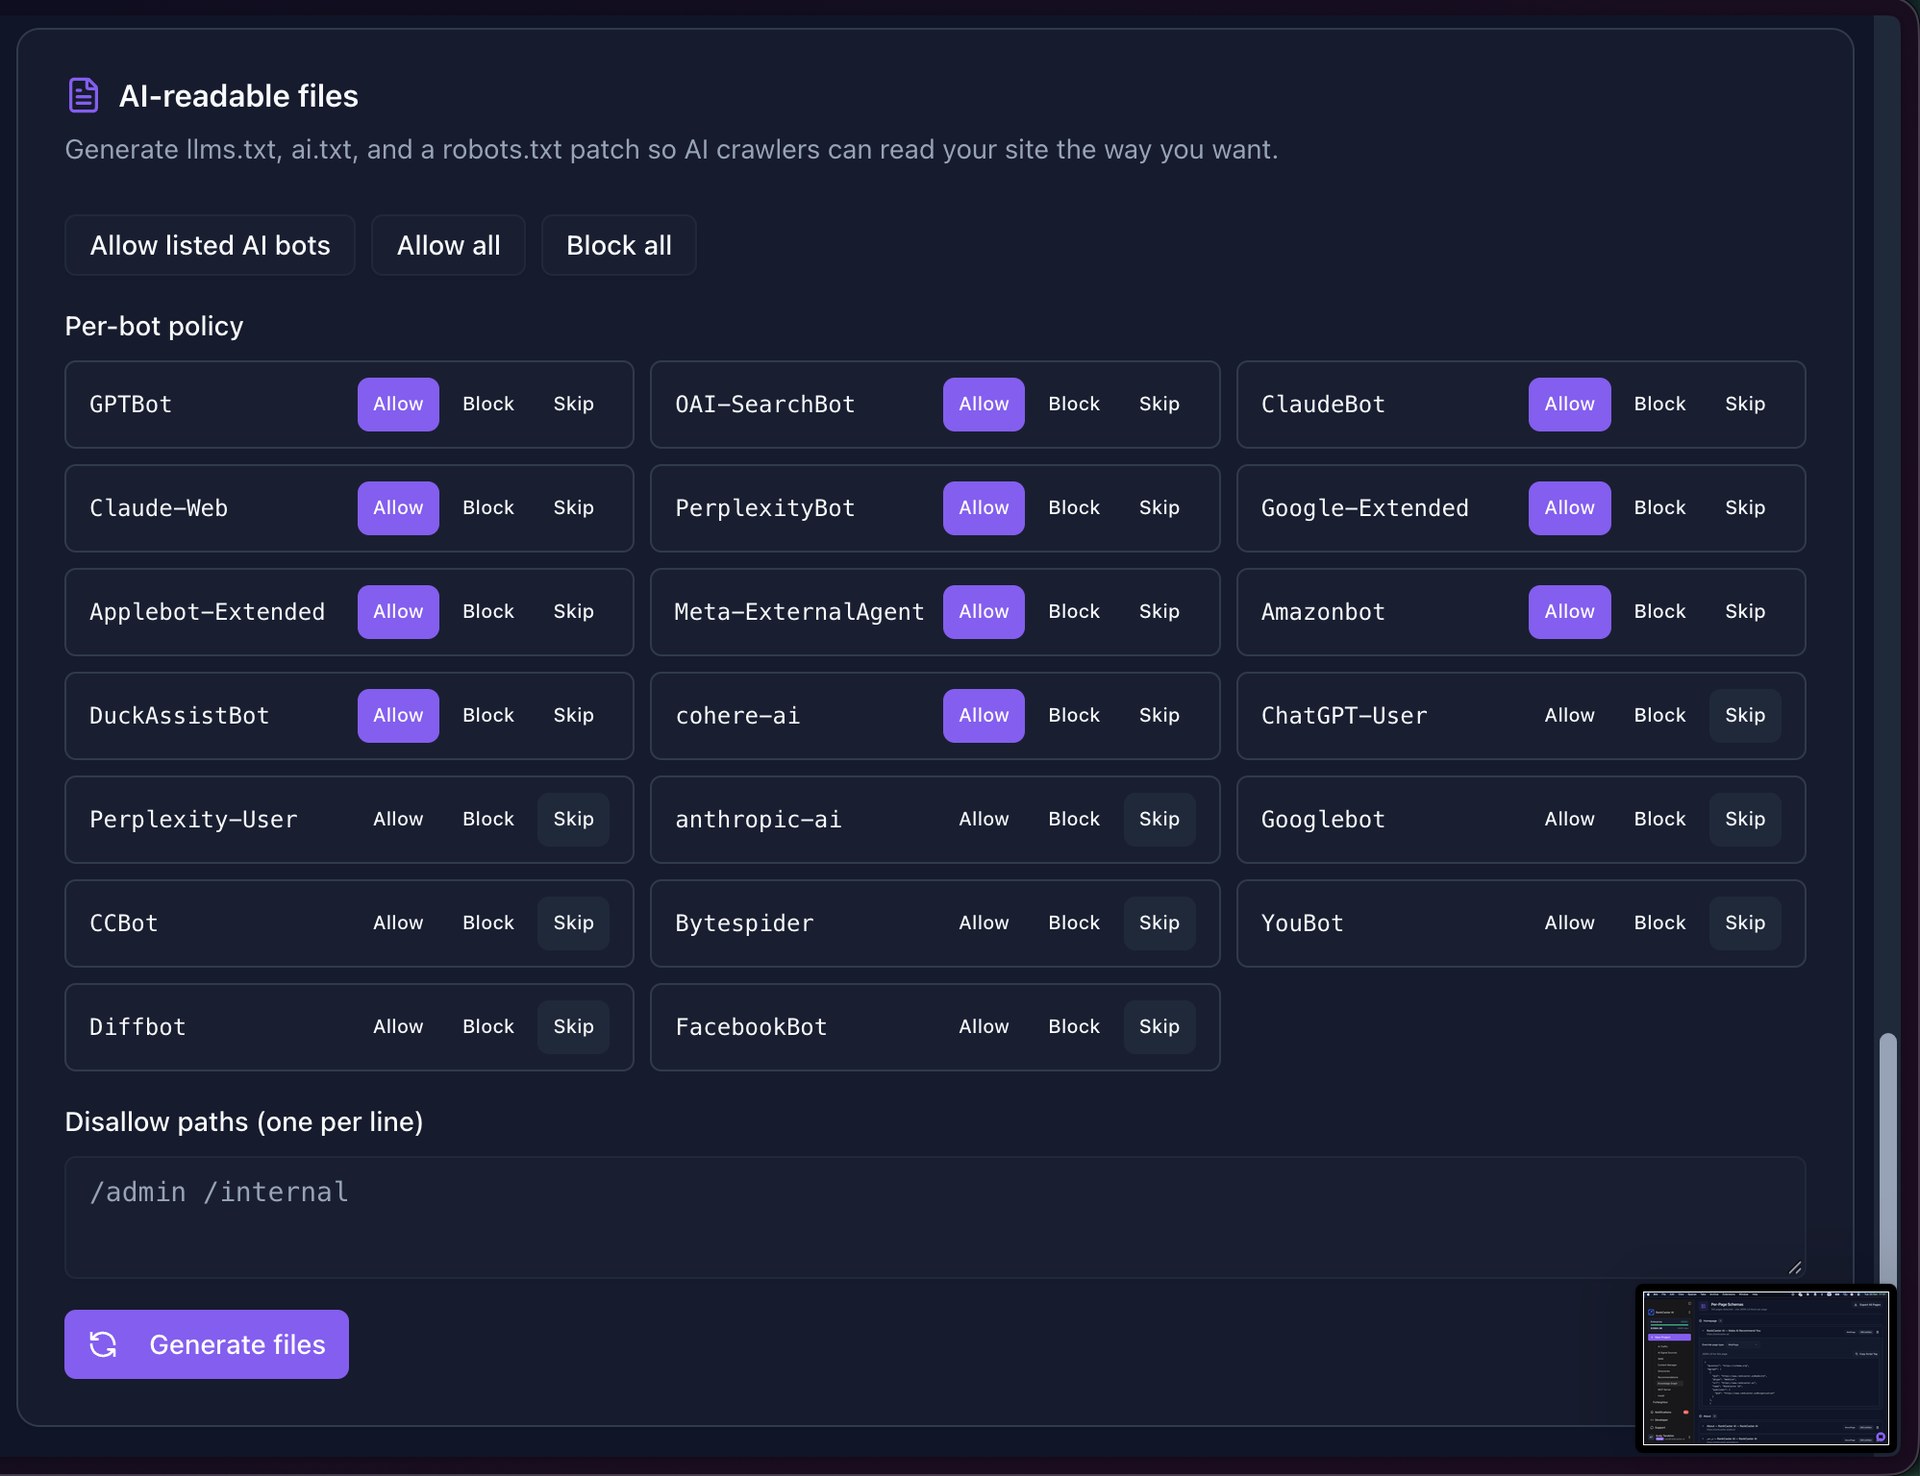
ツールが 20 以上の AI ボット向けの正しい設定を生成し、AI 向け要約ファイルを組み立て、サイトに貼り付けるだけの完成テキストを渡します。別途、ステップ 4 の 105 の技術条件をチェック — サイトは JavaScript なしでボットに配信されているか、何かを誤ってブロックしていないか、ボットにユーザーと異なるものを見せていないか。
05 · ステップ 5 / 9
AI が引用しやすい形にする
アウトカム — 主要ページが短い回答型段落で書かれ、AI が理解できるマークアップでタグ付けされている。
なぜこのステップか
AI は答えがすでに組み立てられている場所から引用します。答えが 4 つの段落に散らばっていれば、AI は 1 つにまとめた競合を引用します。
マークアップ (Schema.org) はページ上の目に見えないラベル — AI に「これは何を見ているか」を伝えます (製品、記事、会社、人物)。それがないと AI は推測し、よく間違えます。
何をするか
- 1.トップページを歩いて: 各段落は 1 つの質問に答えること — 他の段落に依存せず、単独で。「プラットフォームはネイティブコネクタで Salesforce と連携」で、「我々は主要な CRM と協業しており...」ではない。そういう段落を AI はそのまま回答に落とし込めます。
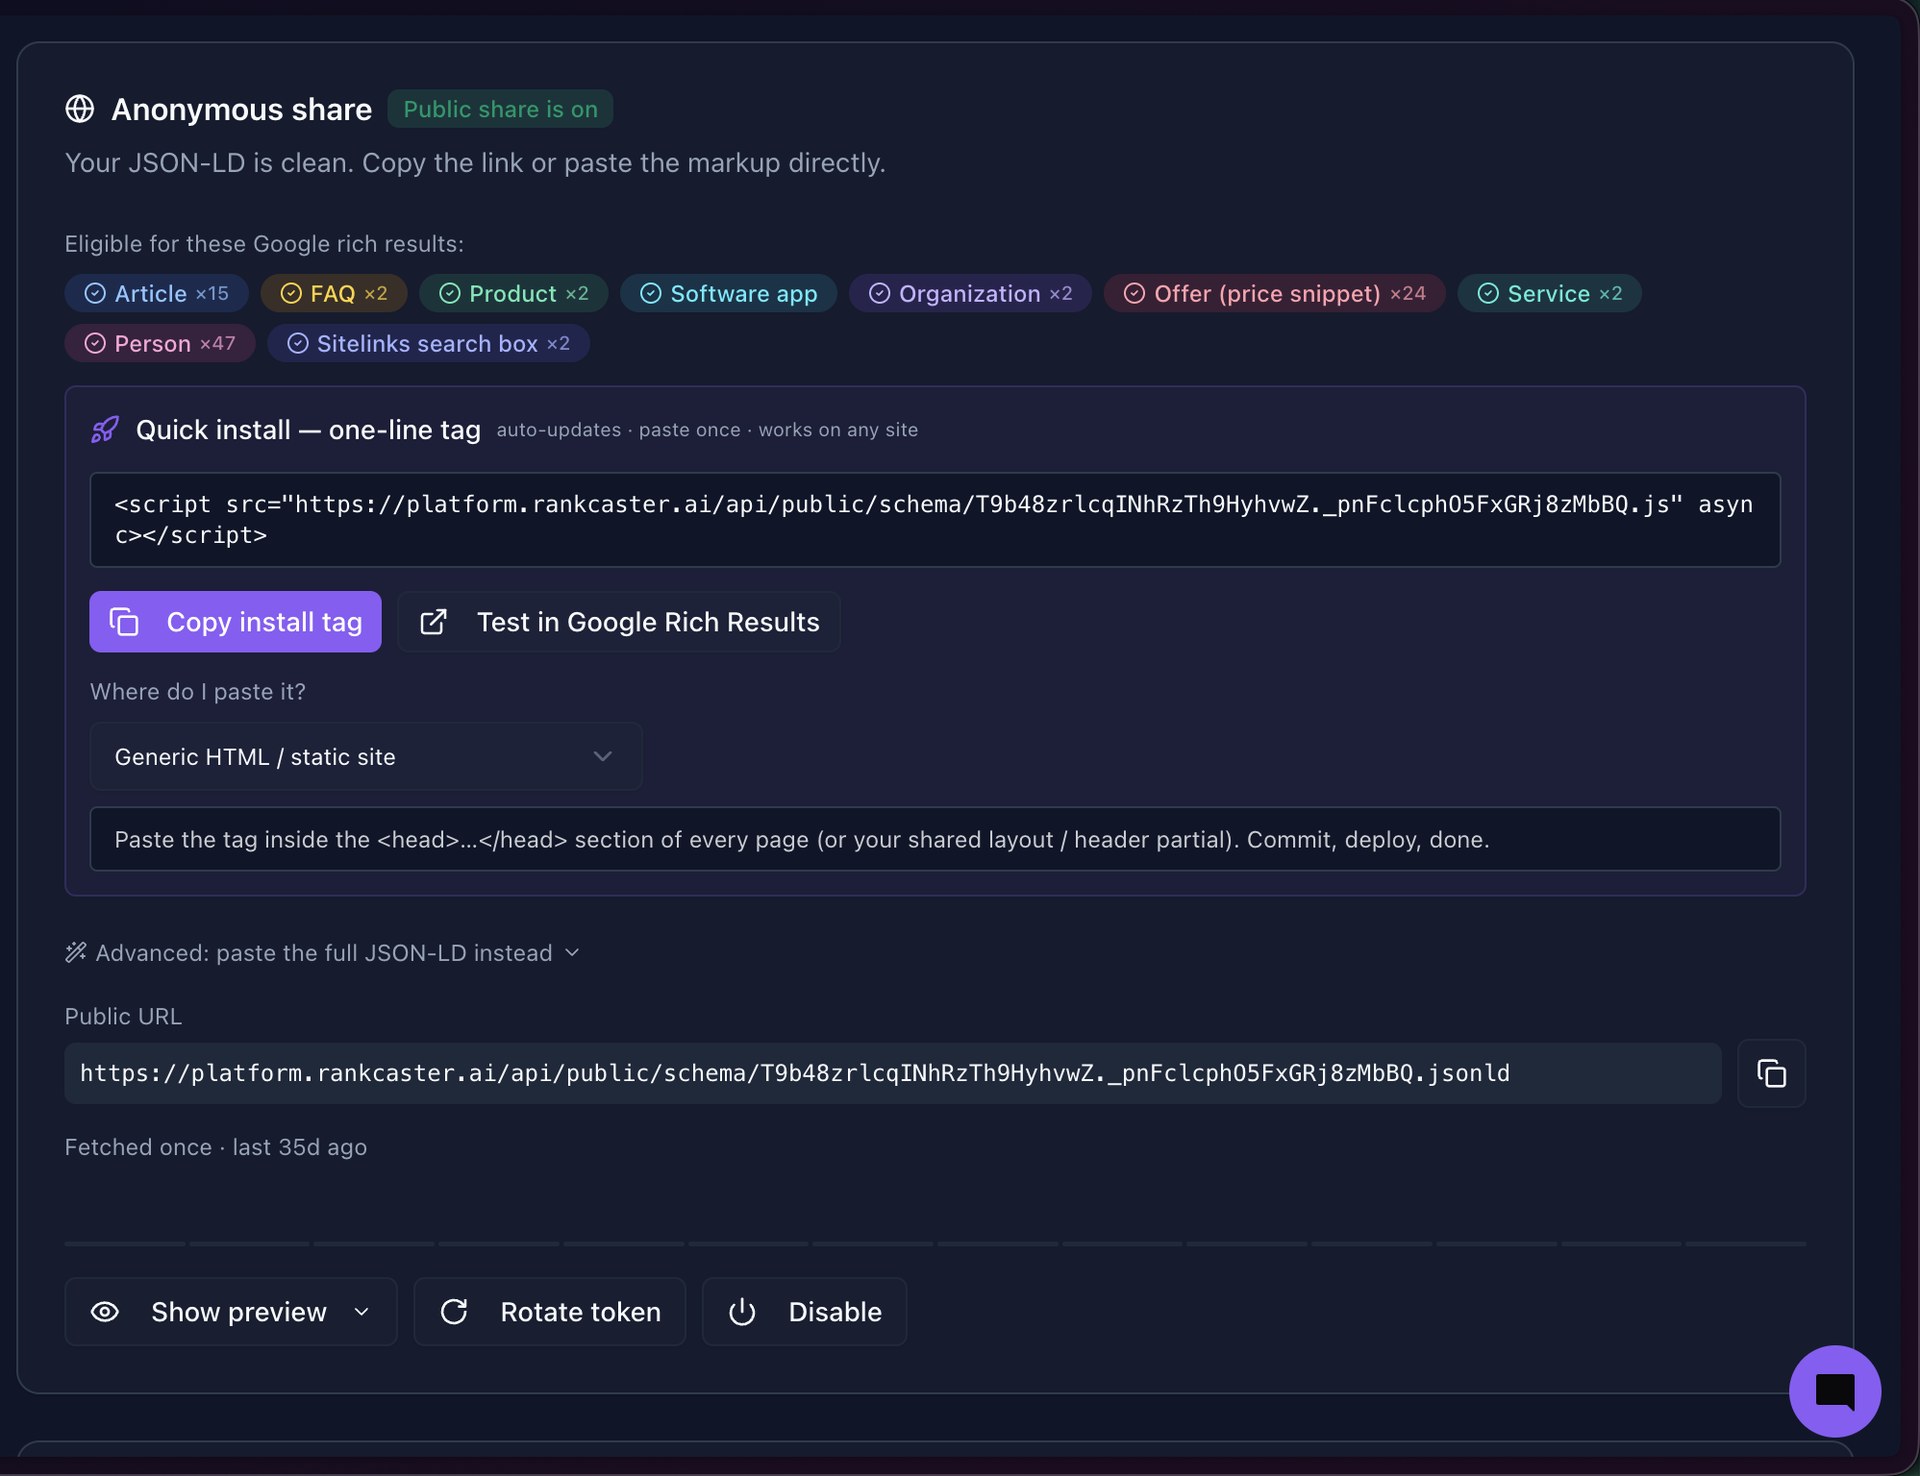
- 2.Schema.org マークアップを追加 — 最低 4 種類: 会社 (Organization)、製品 (Product)、FAQ セクション (FAQPage)、記事 (Article)。研究や用語集を公開しているなら Dataset と DefinedTerm も。
- 3.会社・記事マークアップで sameAs フィールドを埋める — すべてのプロフィールへのリンク: LinkedIn、X、Crunchbase、GitHub、Wikipedia、Wikidata (エントリがあれば)。これで AI はその会社とプロフィールが同一だと理解します。
- 4.マークアップを検証する: Product、Article、FAQ は search.google.com/test/rich-results で。Organization と Person は validator.schema.org で (Google はこれらの型のチェッカーを持っていません)。
完了チェック
ページから任意の段落を文脈から切り離しても、質問への独立した回答として読めること。マークアップの検証がパスすること。
例
Before → After の書き直し
Before (引用不可)
「現代の企業では、チームは分断されたツールに苦しんでいます、そしてそこで我々の出番です — インテグレーションのエコシステムを通じて価値を提供します。」
After (引用可)
「Example CLM はネイティブコネクタで契約を Salesforce と同期し、承認を Slack 経由でルーティングします。50 席のチームなら 15 分以内でセットアップ完了。」
さらに深く — 私たちの調査
RankCaster ではこう見える
Knowledge Graph · Schema.org + Rich Results
ツールがあなたのサイトの全ページに対して AI 向けの「目に見えないラベル」を組み立てます — 会社、製品、記事、著者、FAQ、価格。サイトの head に 1 行貼り付けるだけ、後は自動更新。並行して、Auditor がマークアップに 430 ルール、ステップ 5〜7 のテキスト自体に 63 ルールをチェックします。
06 · ステップ 6 / 9
モデルの「脳内」に入る — 学習データセット
アウトカム — あなたのコンテンツが次世代 GPT、Claude、Gemini を学習させるデータセットの中に存在する — 6〜18 か月後に検索なしでブランドが言及されるように。
なぜこのステップか
AI 可視性には 2 つのチャネルがあります、1 つではなく。1 つめはリアルタイムリトリーバル (ステップ 3〜5): AI が今あなたのサイトに行き、引用し、回答に表示する。2 つめはパラメトリック知識 — あなたのコンテンツがモデルの学習データセットに入り、モデルが内部記憶から言及する、検索なしに。1 つめは数日で動き、2 つめは数か月かかるが、後者こそ長期的にブランドを固定します。
主要ベンダ (OpenAI、Anthropic、Google、Meta、Mistral) はいずれも学習データの正確な構成を公開していません — 公式には「パブリックウェブ + ライセンス元 + 内部データ」の式のみ。つまり唯一のレバーは、あなたのサイトを含むか含まないかが文書化されている公開データセットです。
サイクルは長い。今日 Common Crawl に入ったコンテンツは、月次スナップショットに入り、数週間でクリーンされた派生物 (C4、FineWeb) に、そしてあるモデルの次回 pretraining 実行 — 通常 6 か月〜 1 年先 — に入ります。今日公開 = 6〜18 か月後にモデルで言及。遅いが価値あり: 一度入れば何年も効きます。
何をするか
- 1.学習クローラーを robots.txt で許可する。Common Crawl (CCBot) が主要ゲートウェイ: C4、FineWeb、RedPajama、Dolma、Pile-CC に供給 — 大半のモデルが学習するデータセット。GPTBot (OpenAI 学習)、ClaudeBot (Anthropic 学習) も許可し、Google-Extended トークン (Gemini でのあなたのコンテンツ利用を制御) のブロックを解除。robots.txt の 5 行 — だがこれなしではこのステップは全く動きません。
- 2.「ホワイト」プラットフォームに公開する — すべてのオープンモデルの学習コーパスのメンバーとして文書化されているもの。マーケティング推測ではなく、The Pile、Dolma、RedPajama で文書化された事実: Wikipedia (ブランドが著名なら編集投稿)、arXiv (研究プレプリント)、MIT/Apache ライセンスの GitHub パブリックリポ (The Stack v2 に入る)、Stack Overflow (トピックで高品質な回答)、HuggingFace Datasets Hub (オープンデータセット公開)、Zenodo や Figshare (DOI 付きの学術オープンデータ)。
- 3.Wikipedia 風に書く。FineWeb-Edu 分類器 (現代コーパスで最も広く使われる品質フィルタの 1 つ) は文字通り百科事典的散文 — 中立的トーン、事実 + 出典、定義、構造化された H2/H3 見出し — を押し上げるよう学習されています。ACL 2026 は「Wikipedia 風に書き直す」ことで 7% のドキュメントで分類器判定が反転することを示しました。フラッグシップページにとっては文字通り執筆ガイドです。
- 4.一部のコンテンツに寛容なライセンス。Dolma、Common Corpus、The Stack はライセンスでフィルタリング — Creative Commons (CC-BY)、MIT、Apache-2.0。研究や用語集を CC-BY で公開すれば、オープンコーパスに入り、オープンソースモデル (Llama、Mistral、OLMo、Qwen) に影響する可能性があります。
- 5.包含を検証する。3 つの無料ツール: index.commoncrawl.org (ドメインでの CDX クエリ — CC があなたの URL を見た月次スナップショットを表示)、 wimbd.apps.allenai.org (C4、Pile、RedPajama 内の検索 — サイトの正確な存在を表示)、そして "Am I in The Stack" は GitHub リポジトリ用に HuggingFace 上に。
完了チェック
index.commoncrawl.org の CDX クエリで、あなたのドメインが少なくとも直近 3 つの月次スナップショットに現れること。少なくとも 1 つのゲートウェイプラットフォーム (Wikipedia、arXiv、GitHub、Stack Overflow、HuggingFace Datasets、Zenodo) があなたのコンテンツをパブリックに掲載していること。
例
例 · 学習チャネル用の最小限 robots.txt
# Common Crawl — C4, FineWeb, RedPajama, Dolma への主要ゲートウェイ
User-agent: CCBot
Allow: /

# OpenAI — GPT の学習 (OAI-SearchBot とは別)
User-agent: GPTBot
Allow: /

# Anthropic — Claude の学習
User-agent: ClaudeBot
Allow: /

# Google — Gemini 学習/グラウンディングを制御するトークン (別ボットではない)
User-agent: Google-Extended
Allow: /
他のプロファイルと組み合わせ可能。例: OAI-SearchBot は許可して ChatGPT Search で今見える状態を保ちつつ、GPTBot はブロックして学習包含を望まない。各ベンダは 3 つのボット — 学習、検索、ユーザー起動 — を独立にチューニングできます。
ベンダ自身が言うこと
ChatGPT、Claude、Perplexity、Google、Bing の公式ドキュメント — ポリシー変更のたびに再確認する価値のある一次情報源。
- CCBot — Common Crawl、C4, FineWeb, RedPajama へのゲートウェイCommon Crawl
- GPTBot — OpenAI の学習クローラー (OAI-SearchBot とは別)OpenAI Developers
- ClaudeBot と Anthropic の学習用ウェブクロールポリシーAnthropic Support
- Google-Extended — Gemini と Vertex AI の学習を制御するトークンGoogle Search Central
- Common Crawl CDX インデックス — あなたのドメインがインデックスされているか確認Common Crawl
- WIMBD — C4, Pile, RedPajama をドメインで検索 (About)Allen AI
- The Pile — 22 の文書化されたソース付きデータシートEleutherAI / arXiv
- FineWeb — 百科事典的散文を押し上げるデータセットと edu-classifierHuggingFace
RankCaster ではこう見える
Content Manager · AEO/GEO Auditor
「学習コーパス包含」ツールはどこにも存在しません — これはリアルタイム指標ではなく長期アーキテクチャチャネルです。私たちは 2 つの間接的レバーを持ちます。Content Manager は中立的・百科事典的スタイル — FineWeb-Edu の分類器が押し上げるスタイル (事実 + 出典 + 構造化見出し、マーケティング定型句なし) — で記事をドラフトします。AEO/GEO Auditor は 600 以上のルールの中で、sameAs マークアップが Wikipedia / Wikidata / arXiv / GitHub にリンクしているかをチェックし、権威ある外部リンクが欠けているページを返します。「包含トラッカー」を直接作らないのは — 誰も作れないから、ベンダはコーパスを公開していません。
07 · ステップ 7 / 9
月 3〜4 本の記事を公開する
アウトカム — 追跡プロンプトごとに — あなたのドメイン上の 1 つの回答ページ。
なぜこのステップか
質問に対する自前のページがない限り、AI にはあなたのサイトから引用するものがありません。リンクの唯一の源は他人の公開物で、それが古くなった瞬間、あなたは消えます。
私たちの 8,058 の計測データでは: 質問に自前の記事があるブランドは言及率 35% に到達。何も公開していないブランドは 0.5% で頭打ち。
何をするか
- 1.リストから月 3〜4 問。「比較」と「選定」から始める — 購入者が取引に最も近い。
- 2.質問 1 つにつき記事 1 本。3 つの質問を 1 本に詰め込まない — AI は何を引用すべきか分からなくなります。
- 3.質問をそのままタイトルと最初の段落に入れる (それが AI が回答に落とし込む完成品の答えになる)。ページの見出しは短くし、人間向けに書く。
- 4.記事ごとに — 製品、価格、顧客ページへのリンク。これで AI は記事が孤立したテキストではなく、あなたのサイトの一部だと理解します。
- 5.著者を記載: 名前、役職、会社、LinkedIn リンク。AI は誰が書いたかを重視します。
- 6.最初の 1〜2 週間は計測に何も動きません。正常 — AI は遅れて答えを学び直します。
完了チェック
リストの各質問について、サイト上に質問をタイトルと最初の段落に含む単独ページが 1 つあること。
例
事例 · ポーランドの教育センター
最初の記事を 8 月 26 日に公開。3 週間で AI が週 65 回センターを引用 (元は週 13 回)。「ヨーロッパの SMM コース」という質問は AI が半数の回答で名指しする水準に到達。ルールは単純: 質問 1 つにつき記事 1 本、定期公開 — 1 か月で計測可能な可視性。
さらに深く — 私たちの調査
RankCaster ではこう見える
Content Manager
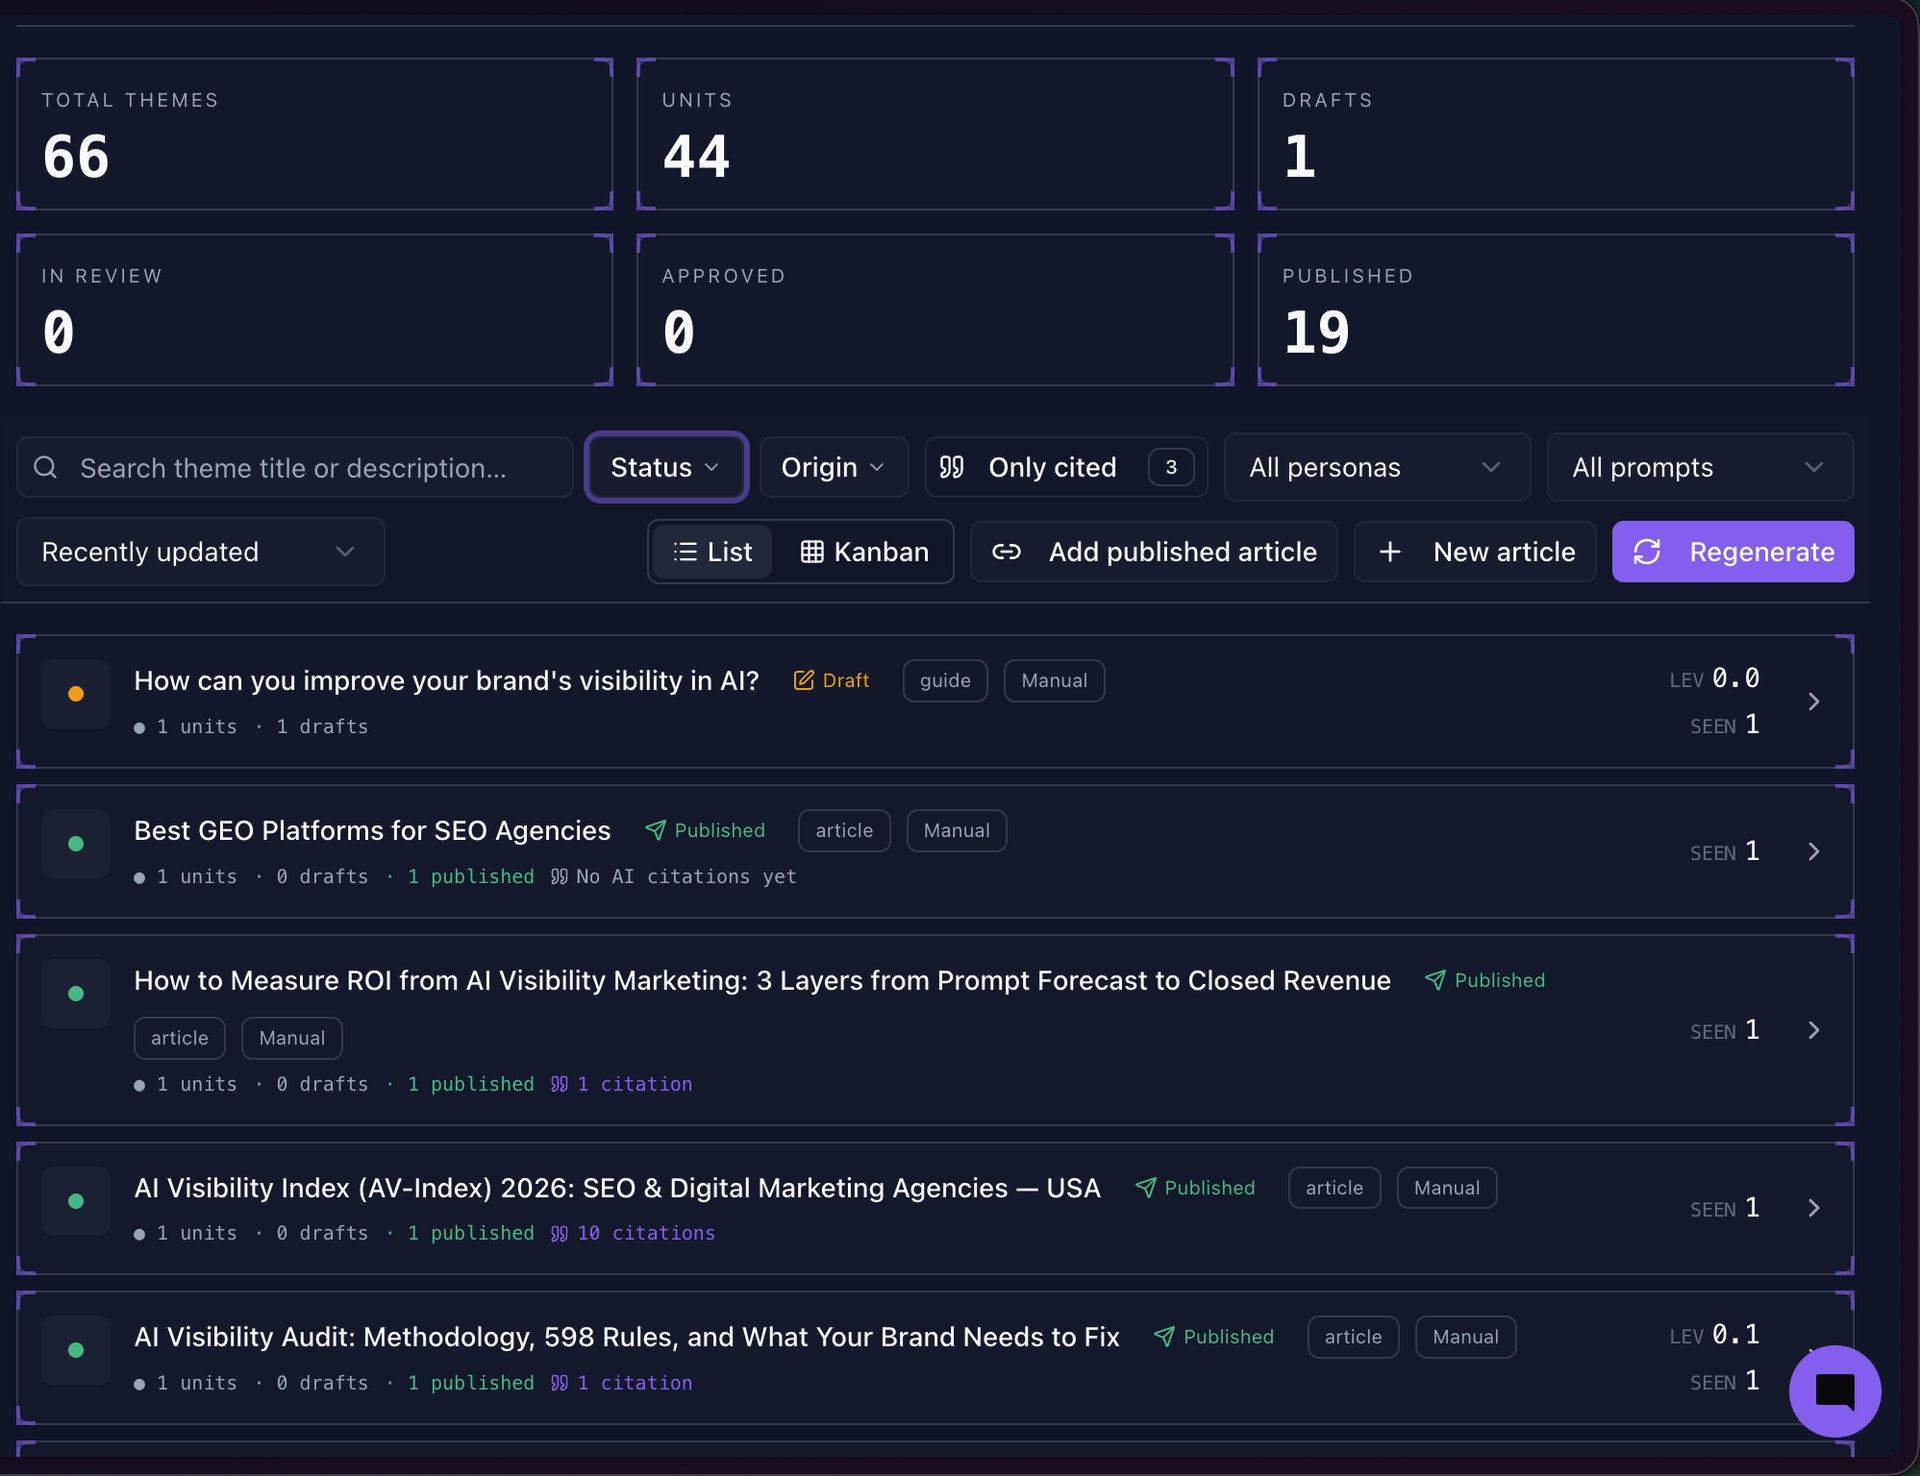
ツールがトピックを提案し、記事を書きます — 単なるテキストではなく、AI が回答に落とし込める形で。公開前に各記事は AI 適合性チェックをパス: 1 段落 = 1 回答、簡潔、マークアップ付き、直接的事実、ステップ 2 の質問に合致。ワンクリックですべての自社チャネルに公開 — 自社ブログ、LinkedIn、Medium、Dev.to、Reddit、企業資産 — 各々を一度連携すれば、1 クリックで同時公開、ソーシャルへの自動リポスト付き。
08 · ステップ 8 / 9
他の人にあなたのことを書いてもらう
アウトカム — 各質問につき — ブランドを言及する外部ページが 2〜3。
なぜこのステップか
AI はサイト自身だけを引用するのを嫌います — 外部の確認が欲しい。私たちのデータでは: 自前ページだけで言及されているブランドは回答の 35%。独立した 2〜3 の出典に引用されているブランドは 58%。
サーフェスは等価ではありません。AI は LinkedIn 記事を喜んで引用 — これがメインの外部チャネル。G2、Clutch、SourceForge などの業界ディレクトリは各 1〜9 の言及を与えるが、LinkedIn が触れないニッチなトピックをカバーします。
何をするか
- 1.ステップ 7 の各記事について、競合がすでに引用されている外部サーフェスを 2〜3 選ぶ。RankCaster の Content Manager → Where to publish でリストが自動組み立てされ、あなたのピッチを受け入れそうな相手の順にランク付けされます。
- 2.AI が実際に引用する業界ディレクトリ・レビューサイト (G2、Clutch、SourceForge、Capterra 等) に登録 — プロフィールを完全に埋める。空か半端なプロフィールは無いよりも悪い、AI は信頼できない出典として扱います。あなた向けの短いリストは Directories セクションに。
- 3.ソーシャル (LinkedIn、Reddit、X) で、サイト上の各記事につき 1 つの投稿、元リンク付き。一貫してやればそれで十分。
- 4.複数ブランドを運営しているなら — 相互に言及させる。私たちの研究では 2 ブランド間の相互言及は各々 664〜698 の言及をもたらしました。
- 5.AI が誰も引用しないサーフェスに時間を無駄にしない。簡単なチェック: ChatGPT に競合について聞く — サーフェスが出典になければ、飛ばしてよし。
- 6.やってはいけないこと。G2 / Capterra で大量レビューを買わない、虚偽の推薦を量産しない — AI エンジンはそのパターンの検知が妥当に上手く、ドメインへのダメージは永続的。実質的な比較のない「あなた vs 競合 N」の定型ページを大量生産しない — URL は増え、信頼と引用は増えません。
完了チェック
リストの各質問につき、ブランドを言及する外部ページを 2〜3 挙げられ、各々がログインなしでブラウザから開けること。
例
例 · 1 本の記事が外部ウェブに出ていく経路
「Ironclad vs Icertis vs Agiloft, ミッドマーケット SaaS 向け」という記事をブログで公開。3 つの外部タッチポイント:
- 1 · G2 — 10 件以上の完全なレビューを含む Contract Management カテゴリのあなたのプロフィール。ChatGPT と Perplexity は製品比較プロンプトの大半で G2 を引用します。
- 2 · LinkedIn Pulse — ステップ 1 の人物の 1 人 (General Counsel) の投稿、あなたの記事にバックリンク。AI は公開 LinkedIn 投稿を出典として拾います。
- 3 · Reddit r/legaltech — 既存の「ミッドマーケット向けの CLM はどれ?」スレッドへのコメント、あなたの記事を deep-dive として指す。AI は Reddit の回答をしばしば引用します。
3 つの異なる出典タイプ (ディレクトリ / ソーシャルネット / フォーラム)。ステップ 7 の各記事で同じルートを繰り返す。
さらに深く — 私たちの調査
RankCaster ではこう見える
Where to publish · Directories · SMM
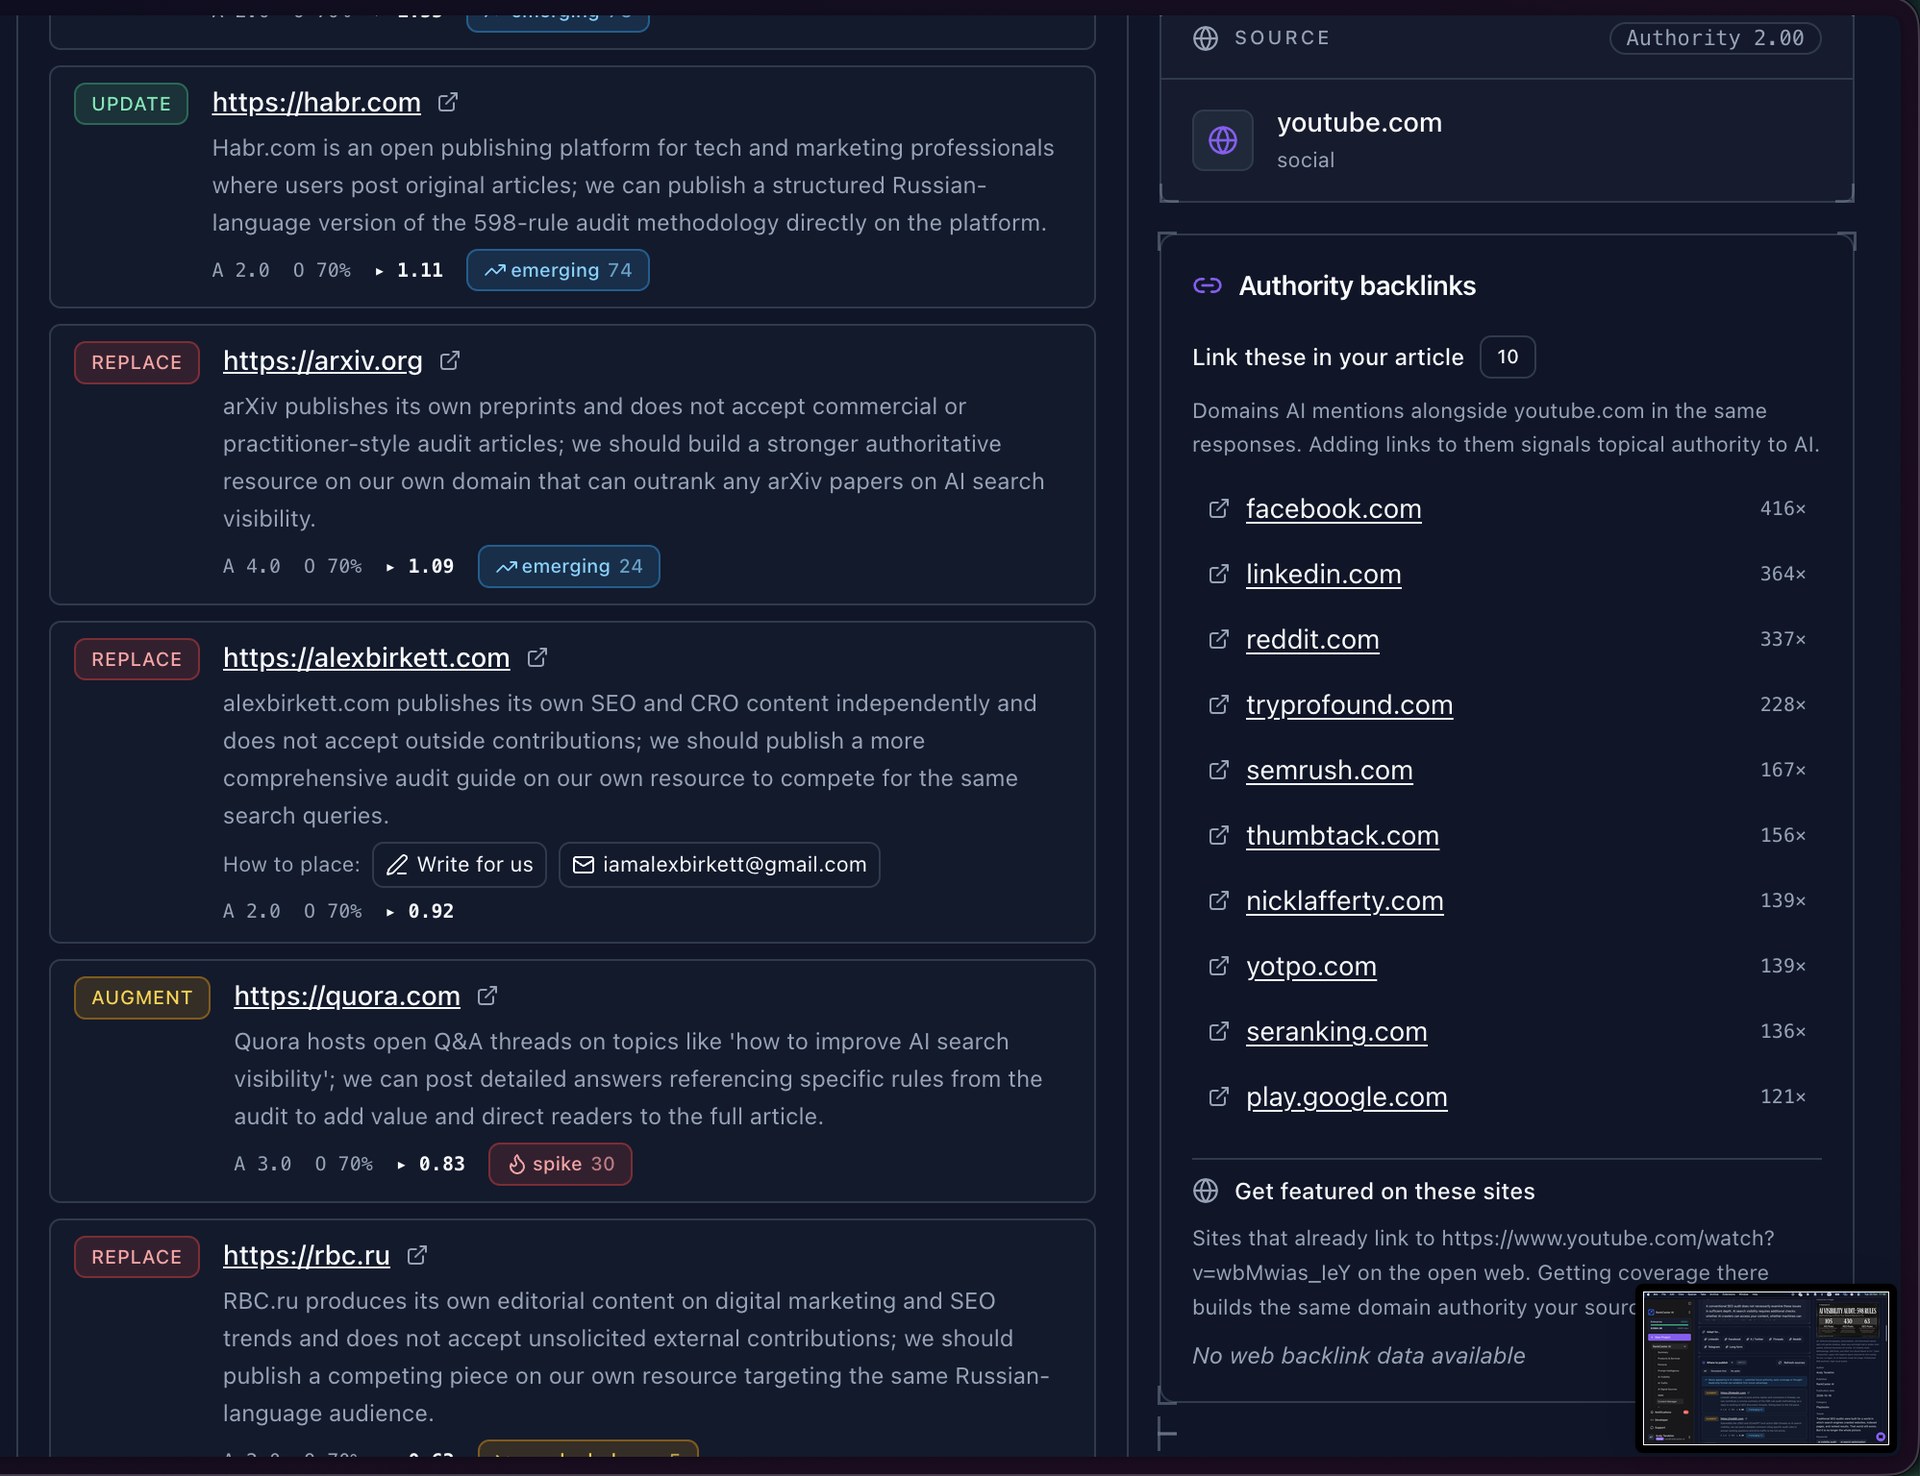
このステップのために繋がった 3 つのツール。Content Manager 内の Where to publish — あなたの記事ごとに、プラットフォームはあなたのトピックがすでに引用されている外部サーフェスを選び、ピッチを受け入れそうな相手の順にランク付けし、具体的なルートを示します: 編集者にメール、ケーススタディをピッチ、ゲスト投稿。各サーフェスにトラッカー (ピッチ送信 → 受諾 → 公開)、公開されれば AI 引用が実際に上昇したか計測します。Directories — カタログ・レビューサイト (G2、Clutch、Capterra、SourceForge) 専用セクション: あなたのプロンプトに対して AI が実際に引用するものを発見、登録済みかをマーク、タイプ (free / paid / invite-only) とあなたのリスティングリンクを表示。SMM — ソーシャルメディア専用セクション: Reddit、LinkedIn、X、YouTube などであなたのブランドや競合を AI が示す議論を発見、あなたの声でワンクリック返信生成・公開 — Reddit と LinkedIn は接続アカウント経由、残りはドラフトとしてコピー。
09 · ステップ 9 / 9
本当の結果を見る
アウトカム — 四半期末までに、AI がどこであなたを名指し始めたかだけでなく、AI ツールから何人の実在の人が訪れたか、それが残りのトラフィック、リード、売上にどうつながったかが見えます。
なぜこのステップか
AI は、どこで見られるかだけでなく、購入者の全経路を変えます。ChatGPT で読み、1 週間後に名前で検索、1 か月後にサイトに直接来る。直接 AI トラフィックだけ見ていると結果の大半を見逃します — 通常の分析で「オーガニック」や「ダイレクト」として現れます。
だから結果を複数の層で同時に計測する: AI 回答自体で何が変わったか (APR と BSCR)、何人の実在の人が AI ツールから訪れたか (サイトがそのトラフィックを別枠でタグ付け)、残りのトラフィックソースにどう波及したか、そして最も重要 — 実際の取引に。
数字には注意。ベースライン APR がゼロ近辺なら相対パーセント増を報告しない (「1% から 3% に上がった — 200% の上昇」) — パーセントポイントで報告 (+2 pp)。相対成長は非ゼロベースでのみ意味あり、さもなくば「APR 3 倍」は意味を失います。
何をするか
- 1.ステップ 3 の計測を繰り返す — 週次か月次。トップ 5 のターゲット質問で四半期に +20 ポイントならプログラムは効いている。どれにも動きがなければ — ステップ 4 とステップ 7 に戻る、技術層かコンテンツに何かが落ちている。
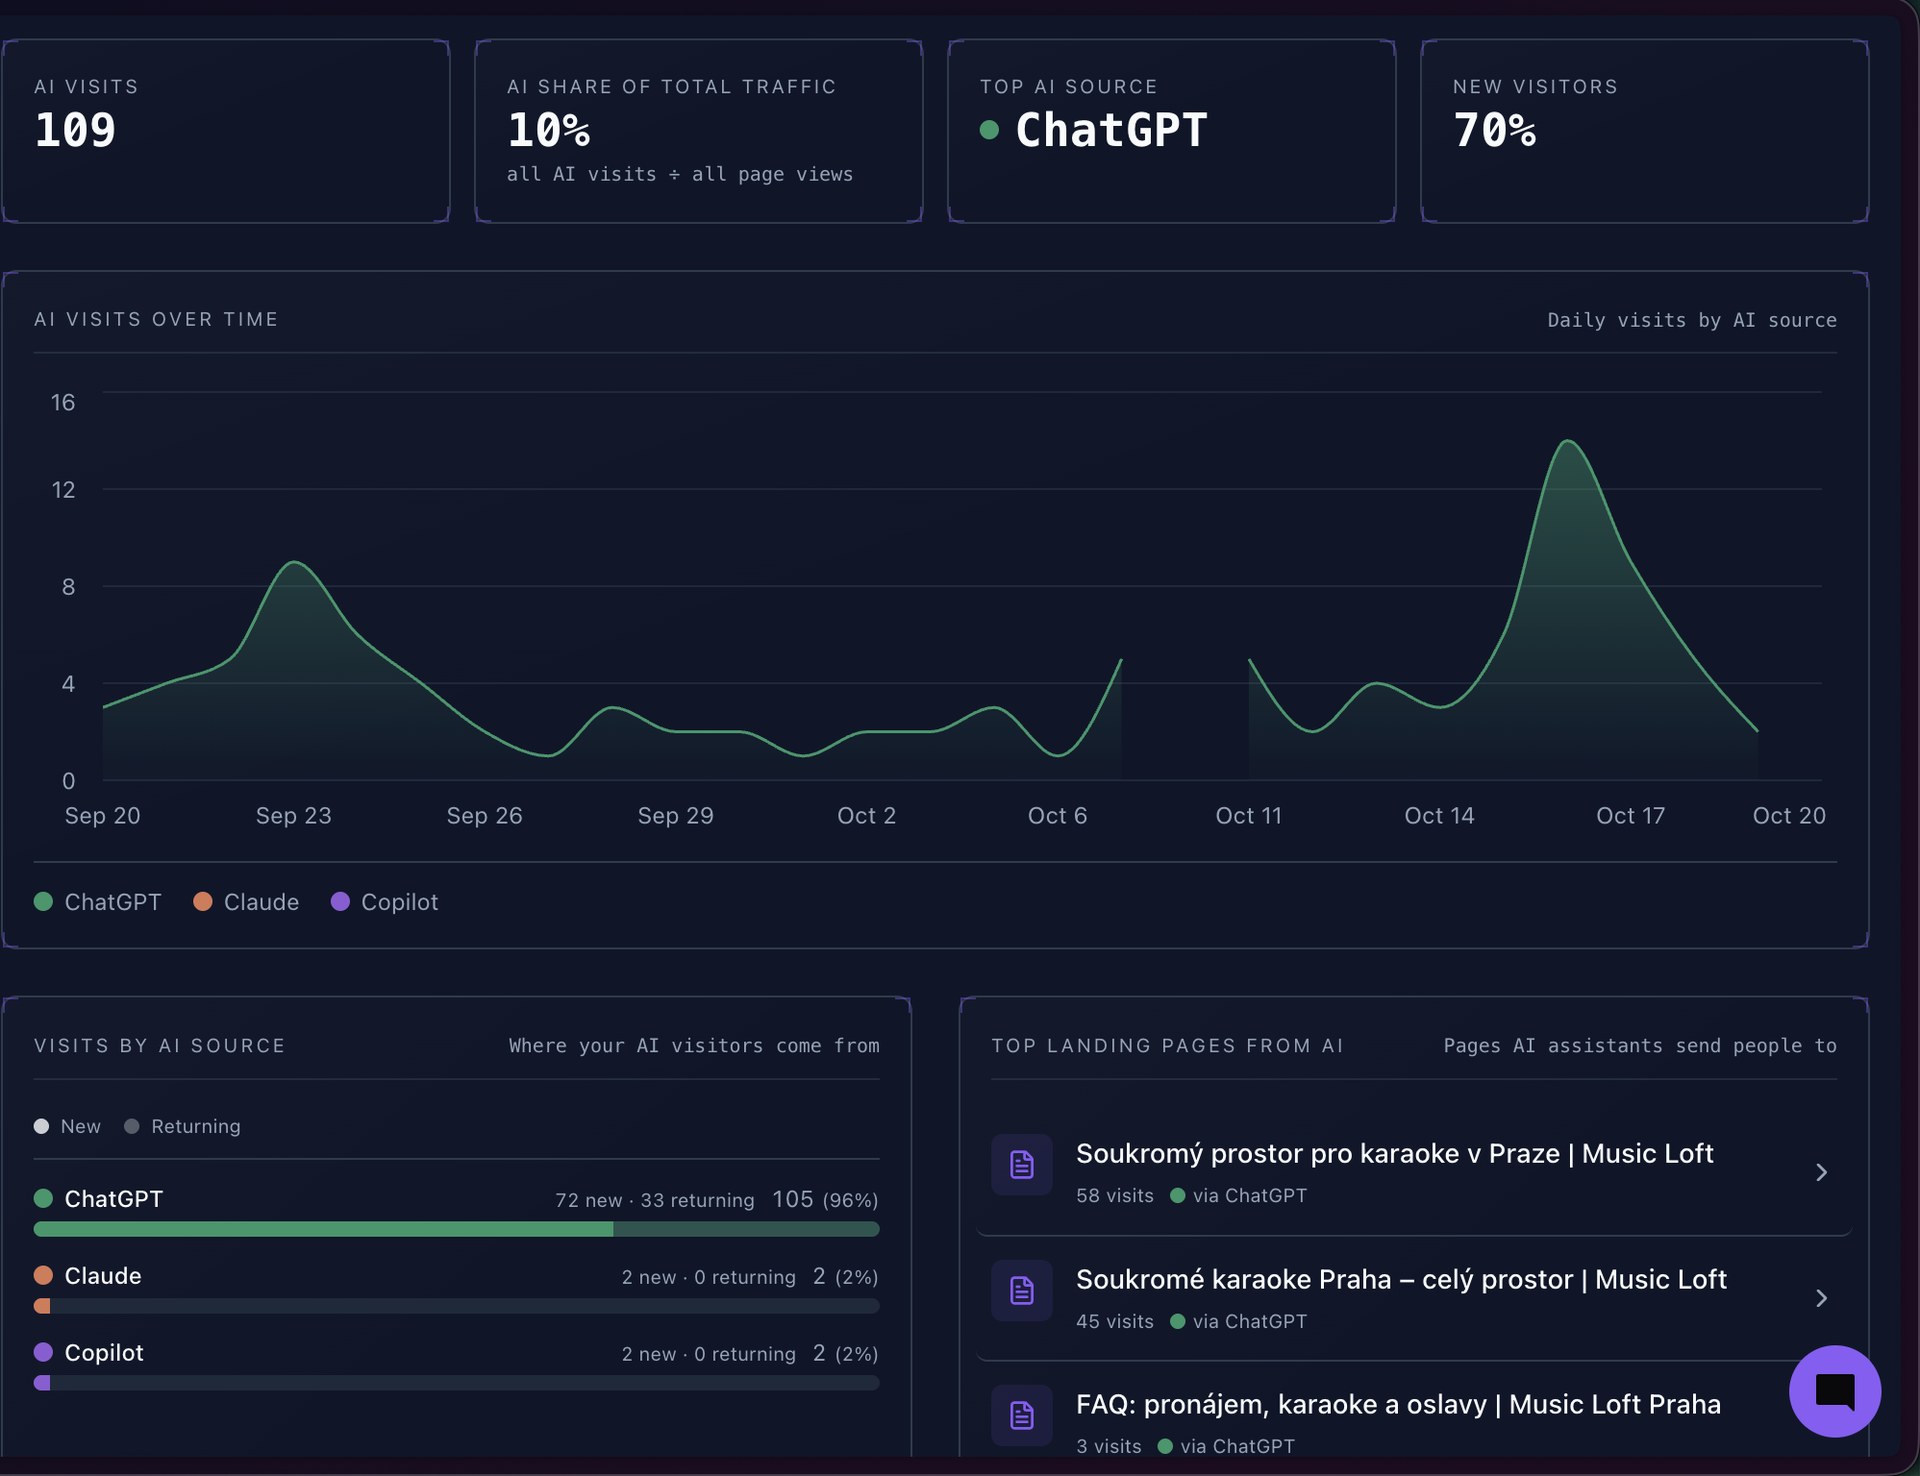
- 2.RankCaster ピクセルをサイトに置く。ChatGPT、Claude、Perplexity、Gemini、Copilot、Google AI Overviews から直接来る訪問者をタグ付けします — 「不明なリファラー」列の代わりに、特定の AI ツールからの実在の人物が見えます。
- 3.並行して通常の分析 (Google Analytics、Plausible など) を監視。2〜3 か月で 3 箇所同時に成長が見える: Google オーガニック (ステップ 7 の記事がそこでもランク)、ブランド検索 (AI であなたを読んで名前で検索)、ダイレクトトラフィック (同じ理由)。
- 4.営業チームが気づく定性シグナル: 顧客がより準備されて到着 — すでにあなたが何をするか知っている、基本的な質問をしない。取引サイクルが短縮。トライアル → 有料の転換率が上昇。ダッシュボードではなくチーム会話にある。
- 5.顧客オンボーディングに質問を追加: 「どうやって当社を知りましたか」 具体的な選択肢付き — ChatGPT、Claude、Perplexity、Gemini、Copilot、Google AI Overviews。2〜3 か月で AI 出典が以前はなかった目に見えるシェアを占めます。
- 6.質問のコントロールグループを維持する。新規コンテンツや外部言及で意図的に強化しない 3〜5 プロンプトを選び、同じ方法論で計測。ターゲット質問の APR が成長しコントロールグループは横ばいなら、それはあなたのプログラムの効果です — 業界全体の AI トラフィック上昇ではない。コントロールグループなしでは区別がつきません。
完了チェック
90 日目に 1 ページで 5 つのことを示せる: 四半期を通した APR と BSCR のトレンド、ピクセル経由の AI トラフィック、通常分析でのオーガニック・ブランド検索の成長、トライアル転換率の動態、「どうやって知ったか」調査での AI シェア。
例
四半期末に見えるもの
- · ターゲット質問の APR と BSCR は 1 桁パーセントから約半数に成長 — AI が大半の回答であなたを名指し。
- · AI Traffic は ChatGPT、Perplexity、Claude からの実在の訪問者を表示 — 以前は空の「不明なリファラー」だった場所に。
- · Google オーガニック も並行して成長 — 記事はそこでもランク。ブランド検索も成長 — AI で読んで名前で来る。
- · 営業チームは顧客がより準備されて到着することに気づく: 何をするか知っていて、基礎ではなく価格と連携について聞く。
- · オンボーディング調査: 新規顧客の目に見えるシェアが最初の出典として ChatGPT や Perplexity を名指し — 以前の調査にはなかったバケット。
具体的な数値はニッチ、取引サイクル、ステップ 7〜8 のペース次第。1〜3 か月サイクルの B2B SaaS で月 3〜4 本の記事なら、2 か月目末には成長が可視化されます。
さらに深く — 私たちの調査
RankCaster ではこう見える
AI Visibility · AI Traffic · Dashboard
ステップ 9 を閉じる 3 つの連携画面。AI Visibility は 7、30、90 日または 1 年の APR と BSCR のトレンドを表示 — いつ、どの指標が落ちたかが見え、各質問を個別に掘り下げられます。AI Traffic — サイトに 1 行のピクセルスニペットを貼り (UI からコピー、head に 1 行)、プラットフォームが ChatGPT、Claude、Perplexity、Gemini、Copilot、Google AI Overviews から来た訪問者をタグ付け。別途の AI Bots セクションがどの AI クローラーがページを叩いているかを表示。メインの Dashboard がすべてを 1 つのファネルに統合: 月に AI が質問に回答する頻度 → そのうち何回あなたが言及されたか → それが何人の実訪問者をもたらしたか。
ステップ 9 以降 · 運用ケイデンス
成果を保ち続ける — 週次ループ
ステップ 1〜9 で追跡プロンプトの 50〜60% 帯に到達します。そこに留まるのは別の規律: 毎週、毎月、永遠に行う 3 つのこと。
重要な質問をすべて週 6 言及以上にする
私たちのデータでは、そこが転換点です。AI がその質問で週 0 回言及するなら、回答の 0.5% に出ます。1〜5 回なら 21%。6 回以上なら半数。「1〜5」と「6+」の間のギャップはほぼ 30 ポイント、計測全体で最大です。まずトップ 5 の質問を週 6 回超えに押し込み、その後残りに取り組む。
週次で再計測し、何が落ちたかを見る
毎週ステップ 3 の計測を繰り返す。2 つの数字のどちらが先に落ちたかを見る。言及率 (APR) が落ちて出典 (BSCR) が無傷なら — 競合が同じトピックで公開し回答で勝った (対処: 同じトピックでより良く書く)。出典が落ちたなら — ページが信頼できるとみなされなくなった (対処: ステップ 4 に戻る — ボットをブロックしていないか、コンテンツが新鮮か、マークアップが揃っているか)。
機能しているページを守る
1 年間で 522 万の言及を追跡しました。AI が 4 か月以上安定して引用するのはページの 3% です。残りは 2〜3 週間で光って消えるか、2 か月かけてゆっくり衰退します。長寿ページの見分け方: 公開後 2 週間で 6 モデル中 4 つが引用しているなら — それは資産、更新し、拡張し、プロモートする。1 つだけなら — 一時的な輝き、投資しない。
RankCaster での動き方
Recommendations · Action Plan
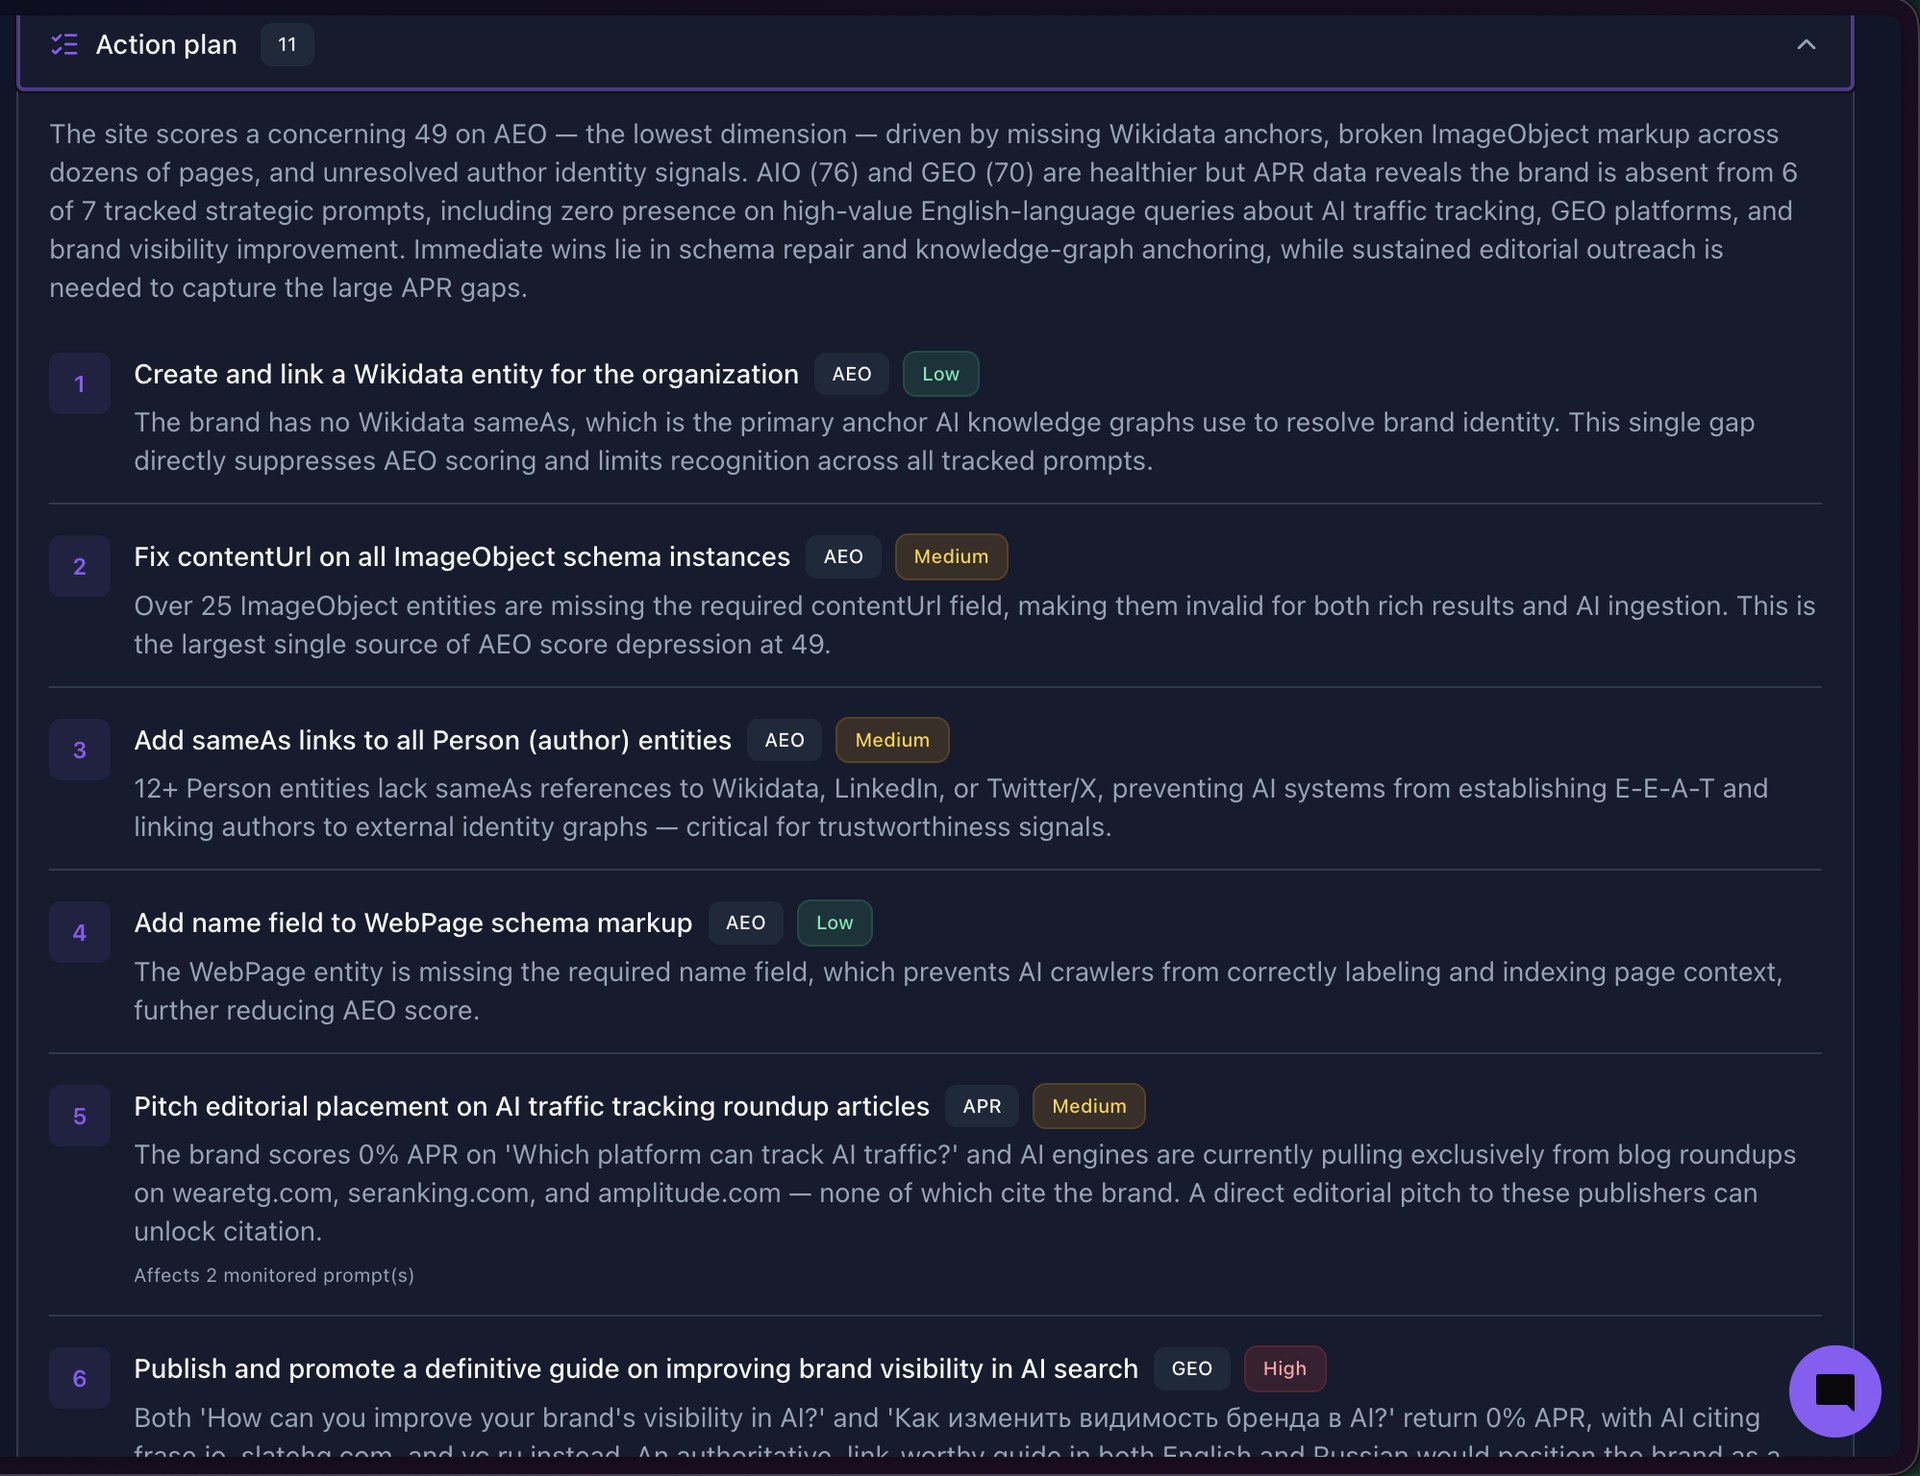
毎週、プラットフォームはサイトの完全監査を再実行し、4 つのスコア (Overall / AIO / GEO / AEO) を再計算、優先順位付きアクションプランを組み立てます — カテゴリ (AEO / GEO / APR) と優先度でタグ付けされた具体的タスク。各タスクに — 何が壊れているか、どのスコアを引き下げているか、なぜ重要かの説明。トップ 2〜3 タスクを選び、1 週間で出荷 — 次の監査でどのスコアが上がったかが見えます。それが次に何をするかで議論しない作業ケイデンス。
タイムライン · 月 3〜4 記事ペース
週ごとの期待値
同じ 8,058 件の観測研究から推奨ケイデンスで前方投影。4 つの実稼働ブランドにわたる観測アンカーであり、マーケティング上の約束ではない。「いつ効くか」と聞いた人と始める前にこの表を共有すべき。
| フェーズ | 公開ボリューム | 期待値 |
|---|---|---|
| 1〜2 週目 | 計測 + 2 本の記事 | 計測には何も動かない — AI は遅れて答えを学び直します。 |
| 3〜4 週目 | 3〜4 本の記事 | AI が週 5〜20 回引用を開始。最強の 2〜3 問では — 回答の 20〜50% に言及。 |
| 2 か月目 | 5〜8 本の記事 | 週 15〜40 言及。能動的に取り組む質問では — 回答の 40〜55% にブランド。 |
| 3 か月目 | 9〜12 本の記事 | 週 25〜60 言及。ターゲット質問への回答の半分にあなたが含まれる。 |
トラブルシューティング
AI があなたに言及しなくなったら何をするか
これが起こる理由は通常 4 つ。それぞれ治療法が違う。原因を誤診すれば、間違った病気を治すことになります。
理由 1 · 競合
すべての回答に入っていたのに — 6 週間で 10 回中 4 回に下落。他サイトでの言及は変わっていない。
対処: AI 回答セットに新しく現れた相手を見る。彼らが公開したものを読む。より新鮮な事実・数字・事例であなたの記事を更新。新しい外部言及を 1 つ追加。
理由 2 · 停止
あるトピックで AI 言及 100% に到達 — そしてそのトピックで出荷を止めた瞬間に 0 に落ちた。
対処: 可視性はフローであってストックではない。古い公開物は単体では何も保持しない。このトピックでステップ 7 のケイデンスに戻る: 新しい記事と新しい外部言及。
理由 3 · 一時的な輝き
5 ページに 1 ページが最初の 1 週間だけ明るく光り、3 か月目には引用が止まる。
対処: 公開から 2 週間後に何モデルがそのページを引用しているかを確認。1 つだけ — 一時的な輝き、代替を用意。4 つ以上 — そのページは資産、守る (更新・拡張・プロモート)。
理由 4 · アクセス切断
robots.txt の編集が偶然 AI ボットのどれかをブロック — Google Search Console は教えてくれない。
対処: ステップ 4 に戻って 6 つのボットすべてが 200 を返すことを検証。これが最もずるい故障 — 通常の SEO ダッシュボードには見えない。
1 ページチェックリスト · プレイブック全体を 13 行で
これを印刷して順番に消化する
- ステップ 1 — 購入会社と社内の取引を動かす 2〜4 人。
- ステップ 2 — その人物が AI で聞く 20 の質問、文中にブランド名なし。
- ステップ 3 — 各質問について 6 モデルで 10 回実行: 言及されたか (APR)、サイトが出典にあったか (BSCR)。
- ステップ 4 — robots.txt で 6 つの AI ボットへのアクセス、サイトに llms.txt、ページは JS なしでテキストを表示、ボットと人間が同じものを見る。
- ステップ 5 — 主要ページに Schema.org マークアップ (Organization, Product, FAQPage, Article)、sameAs ですべての会社プロフィールを列挙。
- ステップ 5 — トップページの各段落が 1 つの質問に単独で答える。
- ステップ 6 — robots.txt で CCBot, GPTBot, ClaudeBot, Google-Extended を許可、ゲートウェイプラットフォーム (Wikipedia, arXiv, GitHub, Stack Overflow, HuggingFace, Zenodo) に少なくとも 1 本の公開。
- ステップ 7 — 月 3〜4 本の記事、記事 1 本 = リストの質問 1 つ。
- ステップ 8 — 質問 1 つにつき、AI がすでに引用するサーフェスに 2〜3 の外部言及。
- ステップ 9 — APR と BSCR の再計測、サイトに AI Traffic ピクセル、通常分析での organic / branded / direct の新鮮な切り口、顧客オンボーディングの「どうやって知ったか」質問。
- 週次 — すべての重要な質問を週 6 言及以上に押し込む。まず深さ、次に新しい質問。
- 週次 — 再計測し、トラブルシューティングの 4 つの理由で診断。
- 週次 — 各ページをチェック: 1 モデルが引用 — 一時的な輝き、4 つ以上 — あなたの資産。
- 月次 — 「プログラム全体が効いているか」に答えるためのフルステップ 3 計測。
よくある質問
APR と BSCR の違いは?
APR は「回答の中で言及された」です。BSCR は「出典リストにあなたのサイトが入った」です。2 つの異なるシグナルです。AI があなたを称賛しつつ G2 の記事を引用している場合、APR は高く BSCR は低いという状態になります。その G2 の記事が書き換えられた瞬間、あなたは回答から消えます。だから両方を計測してください。何かが落ち込んだとき、2 つの数字の差を見ればどこで壊れたかが正確にわかります。
このガイドを実行するのにプラットフォームは必要ですか?
いいえ、すべてのステップは手動でも実施できます。プラットフォームは最も時間のかかる 3 つの作業を加速させるだけです: 購入者ポートレートの作成 (ステップ 1)、6 モデルでの計測 (ステップ 3)、AI 検索に対するサイトの技術的適合性チェック (ステップ 4)。無料監査は約 10 分でそれを行います。
最初の結果はいつ見えますか?
月 3 本の記事ペースで、目に見える変化は 4 週目に現れます。2 か月目末には AI がターゲットの質問の回答の 40〜55% であなたを言及します。3 か月目には 50〜60% です、ステップ 8 の外部施策も並行して走っていれば。実例: 米国の施工業者マッチングプラットフォームが 6 週間で言及率を 6.3% から 14.4% に引き上げました。
追跡すべき AI モデルはいくつですか?
最低でも異なるファミリーから 2 つ (ChatGPT と Gemini で十分)。ただし 6 モデル全部が同時に引用するページは、1 モデルだけが引用するページより 2〜3 倍長く生き残ります。だからリソースが許せば 6 つすべてを計測してください。長期資産になるページを見分けるシグナルにもなります。
ステップ 7 やステップ 8 を飛ばせますか?
可能ですが、天井に当たります。自社記事のみ — 最大 35% の言及率。外部のみ — 最大 40%。両方合わせて — 58%。これらは代替ではなく、同じ機械の 2 つの部品です。
モデルの学習データセットに入ること (ステップ 6) は何をもたらし、いつ回収されますか?
ステップ 6 は長期チャネルです: あなたのコンテンツが学習コーパス (Common Crawl → C4/FineWeb → 次世代モデルの pretraining) に入り、次のバージョンの GPT、Claude、Gemini が検索なしに「内部記憶」からあなたに言及するようになります。サイクルは長い — 公開から出現まで 6〜18 か月。リトリーバル (ステップ 3〜5 は数日で効く) の代替ではなく、ブランドを何年も固定する並行チャネルです。最低参入条件: robots.txt で CCBot、GPTBot、ClaudeBot、Google-Extended を許可 + ゲートウェイプラットフォーム (Wikipedia、arXiv、GitHub、Stack Overflow、HuggingFace、Zenodo) に 1 本の公開。
Google 1 位のページが AI に引用されないことがあるのはなぜですか?
Google トップ 10 と AI が引用する出典の重なりはおよそ 3% にすぎません。AI が好むのは直接的な回答を含む短い段落、Reddit や YouTube の議論、Schema.org マークアップです。回答が段落に分散した長い「SEO 最適化」ページは Google ではランクするものの ChatGPT には入りません。ステップ 5 で修正します。
通常の SEO と何が違いますか?
計測対象が異なり (Google の順位ではなく AI 回答の中の言及)、シグナルが異なり (リンクやキーワードではなくマークアップと外部サイトでの言及)、コンテンツの形が異なり (長いキーワードページではなく短い回答段落)、1 回だけのチェックではなく繰り返し計測する — AI は毎回少し違う答え方をするから。
RankCaster が Ahrefs や Semrush にできないことは?
古典的な SEO ツールは Google の順位と被リンクを測ります。RankCaster は、誰に売るのか、その会社の誰が AI で質問するのかから始まり (ステップ 1)、あなたの質問に対する言及と出典を 6 モデルで同時に計測し (ステップ 3)、AI 向けのマークアップとプロフィールを組み立て (ステップ 5)、どの AI ツールからサイトに訪問者が来たかを表示します。
あなたのサイトでベースラインと 600 以上のルール監査を実行
無料、レポート準備完了までサインアップ不要。エンジン別のプロンプトごとの APR、優先順位付き AIO/AEO/GEO 修正リスト、ステップ 5〜8 で埋めるべき到達ギャップを返します。
これを継続的に動かす準備ができたら — 料金 または GEO プラットフォーム比較を参照。
出典: 600 以上のルール方法論、 7 戦術プレイブック、そして 8,058 件観測研究。このページの数値はそのいずれかに由来。